<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">

  <title><![CDATA[HJ的技术杂谈]]></title>
  <link href="https://www.rowkey.cn/atom.xml" rel="self"/>
  <link href="https://www.rowkey.cn/"/>
  <updated>2026-09-29T12:56:41+00:00</updated>
  <id>https://www.rowkey.cn/</id>
  <author>
    <name><![CDATA[HJ]]></name>
    <email><![CDATA[superhj1987@126.com]]></email>
  </author>
  <generator uri="http://octopress.org/">Octopress</generator>

  
  <entry>
    <title type="html"><![CDATA[从 AI 编码到团队交付：企业 AI-Native 的落地路径]]></title>
    <link href="https://www.rowkey.cn/blog/2026/09/17/ai-native-team-delivery/"/>
    <updated>2026-09-17T21:54:25+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/09/17/ai-native-team-delivery</id>
    <content type="html"><![CDATA[<p>代码写得更快了，需求为什么还在排队？</p>

<p>这可能是企业引入 AI 编码工具后，最值得追问的问题。</p>

<p>工程师可以很快生成一段实现，但产品口径尚未确定；Agent 已经完成修改，却不了解另一个服务的隐含依赖；测试全部通过，上线后才发现验收标准漏掉了关键场景。</p>

<p>编码速度的提升是真实的，交付流程中的等待、返工和协作成本也是真实的。当一个环节加速，原来被它掩盖的问题就会显现。</p>

<p>最近看了一些企业 AI-Native 实践分享，也与正在推进转型的 CTO、技术负责人交流，我越来越关注一个问题：<strong>怎样把个人使用 AI 的能力，变成团队能够持续复用的交付能力？</strong></p>

<!-- more -->


<h2>一. 什么叫 AI-Native？</h2>

<p>在我看来，AI-Native 体现为产品、组织和认知方式的变化。是否使用 AI 工具、年龄多大，都不足以判断一个人或一家企业是否具备这种思维。</p>

<p><strong>第一，产品探索从模型能力边界出发。</strong> 先通过实际使用与测试，摸清模型已经能稳定完成什么、哪些能力仍不可靠，再探索由此成为可能的产品形态。对未来能力可以作假设，但需要持续验证。这并不意味着忽略用户需求，而是让技术能力参与定义产品机会，再由真实用户价值检验方向。模型成为产品设计的基础，也就有机会改变整个工作流。</p>

<p><strong>第二，组织围绕人与 Agent 的组合分工。</strong> 面对一组任务，先考虑哪些判断由人承担，哪些执行可以交给 Agent，怎样验收、何时升级，再决定岗位与协作方式。一个人可以协调多个 Agent，承担更完整的交付责任。组织设计的重点随之转向任务、能力、权限与责任之间的匹配。</p>

<p><strong>第三，用一手信息和亲自验证形成判断。</strong> 论文、模型卡、官方文档、代码仓库中的问题讨论，以及自己运行的评测，应成为判断能力边界的重要依据。行业分享与交流可以提供线索，但关键结论要回到原始材料，并在自己的任务上验证。特别是决定采用什么模型、开放多大执行范围时，实测结果应当比转述更有分量。</p>

<p>这三点也构成了我理解企业落地的起点：<strong>产品围绕模型能力探索，组织围绕人机协作重构，判断依靠一手证据校准。</strong> 后文的 Agent Readable，则是把这种思维落实为工程能力的一项基础：让任务、知识、工具与验收规则真正能够被 Agent 使用。</p>

<h2>二. 企业 AI-Native 的两条落地线</h2>

<p>在企业内部，我倾向于把 AI-Native 分成两部分：<strong>AI-Native 产研</strong>与<strong>Agentic 业务与职能</strong>。</p>

<p><strong>AI-Native 产研，也就是 Vibe Coding 的工程化。</strong> 它面向研发交付，关注需求如何变成 Spec，代码库如何被 Agent 理解，代码生成、测试、评审和发布如何形成可追踪的链路。它的结果是更稳定的产品迭代能力，而不只是更快地写出代码。</p>

<p><strong>Agentic 业务与职能。</strong> 它面向数据分析、客服、运营、销售、测试等具体工作，关注业务系统能力如何通过 MCP 或 CLI 暴露，岗位流程如何沉淀为 Skill，Agent 如何进入已有协作场景，并在权限范围内完成任务、提交结果和请求人工介入。</p>

<p>两条线的用户和交付物不同，但底座应当共享：模型接入与 Token 治理提供资源和度量，Agent Readable 提供代码、数据和业务上下文，权限与审计提供边界，测试和评审提供验证，知识治理负责把有效经验沉淀下来。</p>

<p>可以把它理解成同一套企业 AI 能力的两个出口：产研线把能力用于“构建和维护产品”，业务线把能力用于“运行和改善业务”。如果只做 Vibe Coding，企业可能获得更快的研发，却仍让业务流程依赖人工传递；如果只做业务 Agent，缺少工程化底座又容易出现权限不清、知识过期和结果不可复核。两条线应分别试点、共享底座，再通过统一指标比较实际交付价值。</p>

<h2>三. 从认知到落地</h2>

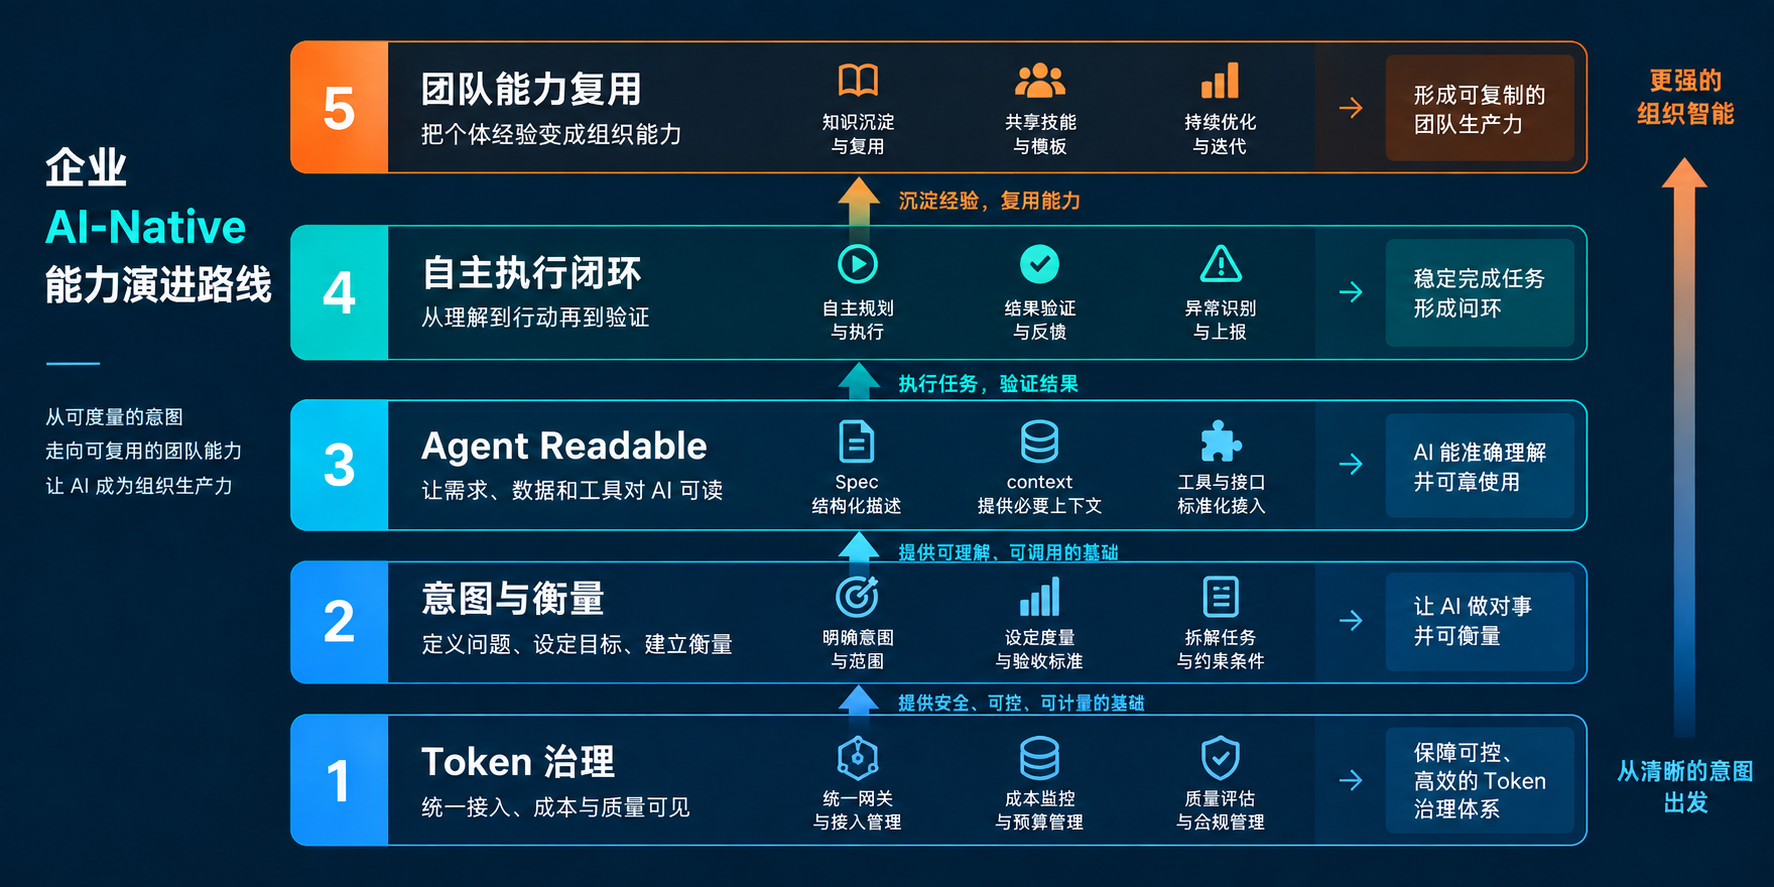
<p>结合团队落地经验，本文尝试给出一条工程落地路径：以 Token 治理保障接入与度量，明确意图与责任，建设 Agent 可理解的上下文，随后把执行、验证和异常处理接成闭环，最后让有效经验在团队中积累。</p>

<p>文中的实践经过匿名化整理，保留建设方法与阶段性经验，不涉及具体企业、产品及实施排期。案例中的阶段状态描述的是相应实践过程，不代表当前部署情况。</p>

<p><img src="https://www.rowkey.cn/images/2026-09-17-ai-native-team-delivery/ai-native-evolution-v4.png" alt="" /></p>

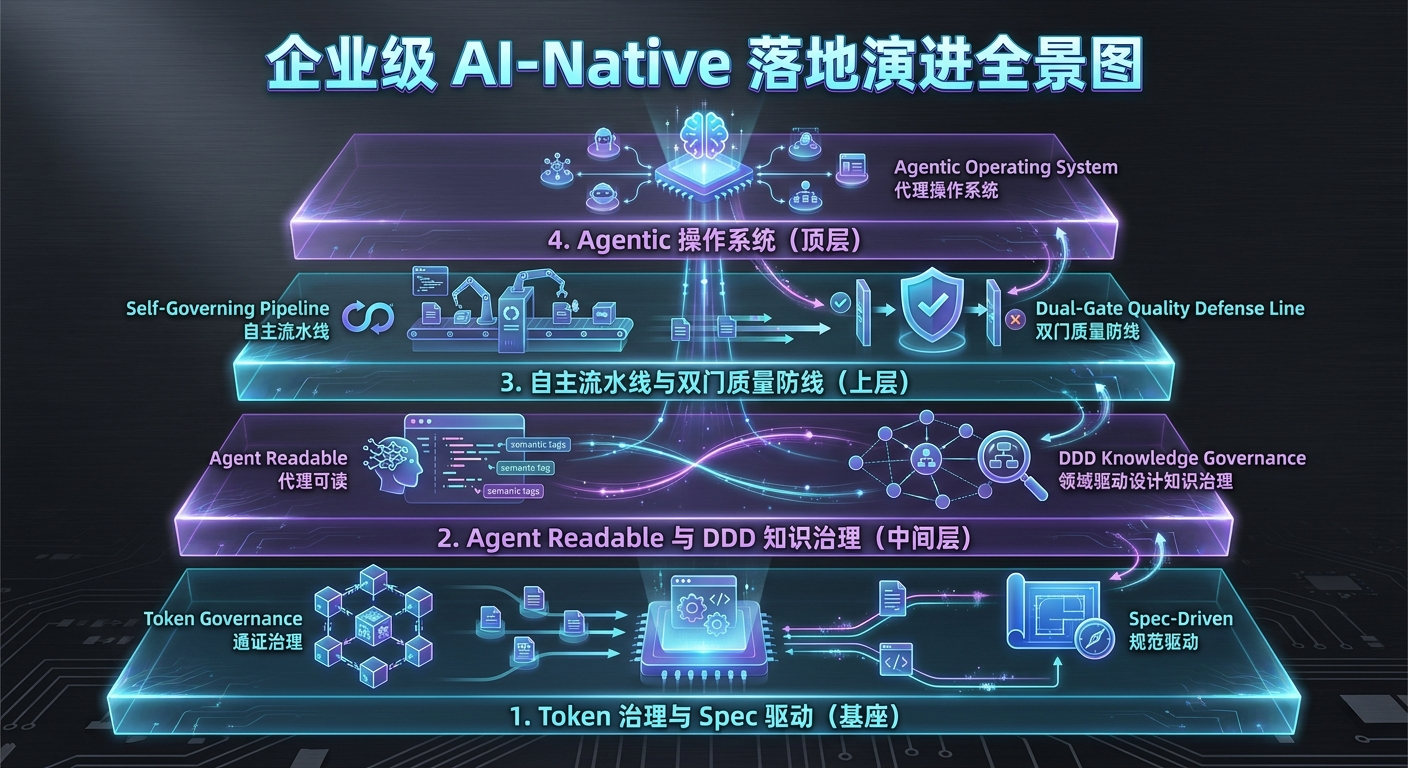
<p>这张图表达的是<strong>时间上的演进路线</strong>：企业通常先解决接入和投入可见性，再把任务意图说清楚，接着建设 Agent 可理解的上下文，最后把有效做法沉淀为团队可以复用的能力。它不是严格的瀑布流程，试点中几项能力往往会并行建设，但成熟度大致沿着这个方向推进。</p>

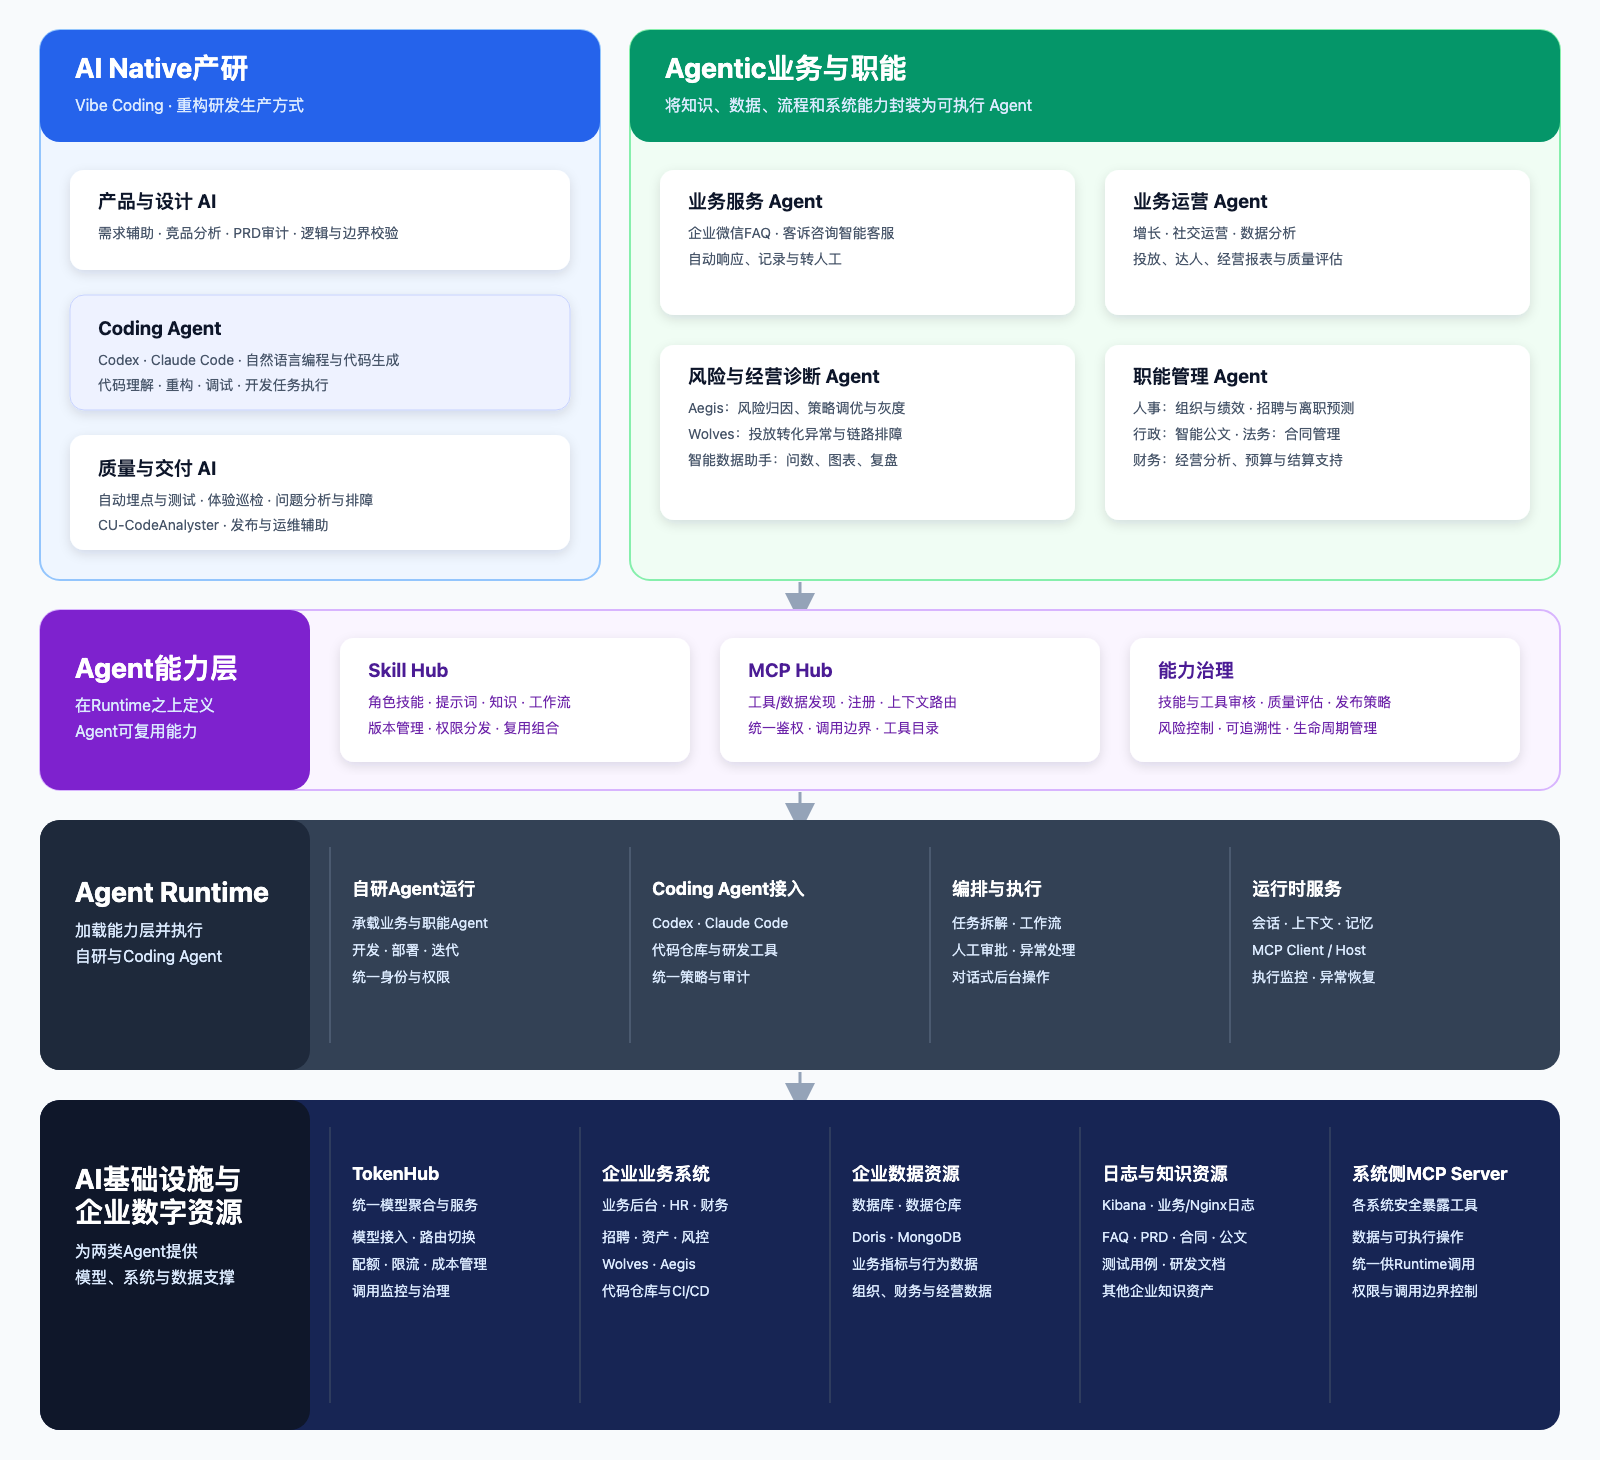
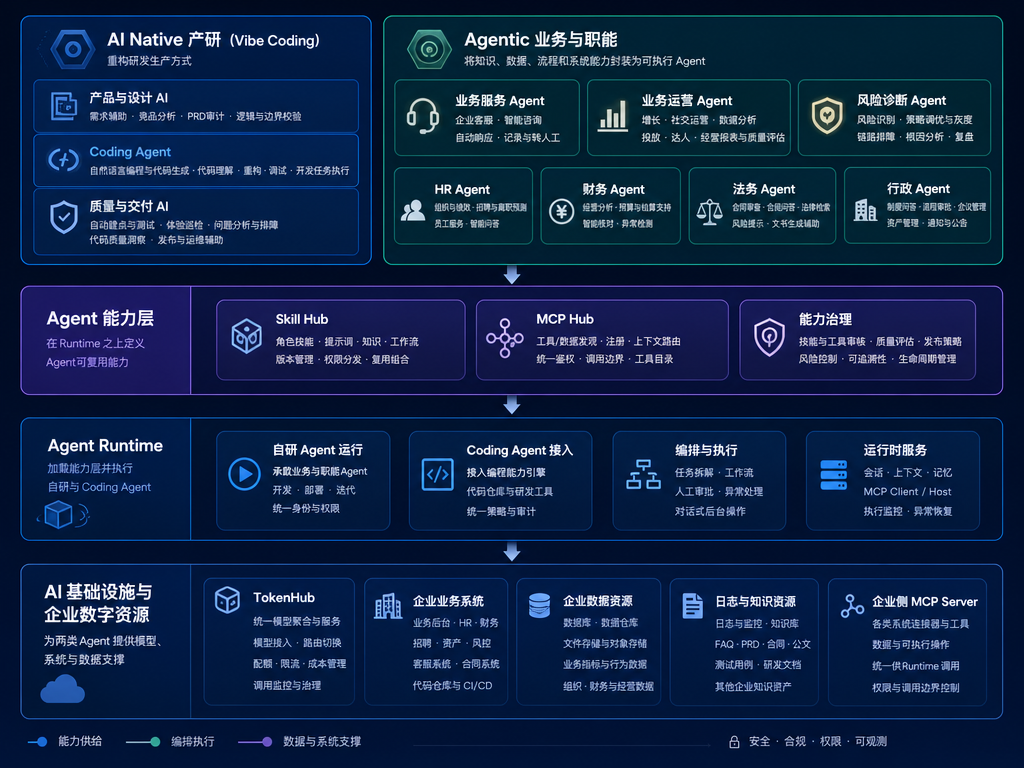
<p>如果把问题换成“这些能力最终由什么承载”，需要看另一张图。下面的架构图表达的是<strong>空间上的分层关系</strong>：上层是 AI-Native 产研和 Agentic 业务与职能两条落地线，中间是 Agent 能力层与 Runtime，底层是模型接入、Token、企业数据、知识和系统资源。箭头表示能力依赖，不表示项目必须按自下而上的单线顺序交付。</p>

<p><img src="https://www.rowkey.cn/images/2026-09-17-ai-native-team-delivery/ai-native-architecture-v2.png" alt="" /></p>

<p>两张图合起来，分别回答“能力如何逐步成熟”和“成熟后的能力如何被组织承载”。不同业务、不同风险等级的任务，可以在同一架构上长期采用不同程度的自动化。</p>

<h2>四. Token 治理：让团队用得上、看得清、持续改进</h2>

<p>企业推进 AI，往往先从工具采购、模型接入和账号分配开始。这些工作必要，但它们回答的是“能不能用”，还没有回答“用得是否有效”。</p>

<p>如果把 Token 消耗、AI 生成代码占比或 PR 数量直接作为成绩，团队很容易优化出更多调用、更多代码和更多提交，却没有缩短一次需求真正交付的时间。</p>

<p><strong>Token 是投入，经过验收的交付才是产出。</strong></p>

<p>试点开始前，建议先记录几项基线：</p>

<table>
<thead>
<tr>
<th> 维度 </th>
<th> 要回答的问题 </th>
<th> 可观察指标 </th>
</tr>
</thead>
<tbody>
<tr>
<td> 速度 </td>
<td> 需求从进入到验收，需要多久？ </td>
<td> 交付周期、等待时间 </td>
</tr>
<tr>
<td> 质量 </td>
<td> 交付后是否还要返工？ </td>
<td> 验收退回率、回归缺陷、线上故障 </td>
</tr>
<tr>
<td> 自主程度 </td>
<td> 哪些任务可以在既定授权内完成？ </td>
<td> 同类任务自主完成率、人工介入原因 </td>
</tr>
<tr>
<td> 成本 </td>
<td> 完成一个合格任务花了多少资源？ </td>
<td> 模型、运行环境、人工审核与返工总成本 </td>
</tr>
</tbody>
</table>


<p>比较时应尽量保持任务类型、复杂度和验收口径一致。一个简单页面与一次跨服务数据迁移，不能因为都算“一项任务”，就直接比较完成速度。</p>

<p>自主完成率也需要定义清楚。例如，统计范围是“无需中途人工纠偏，达到 PR 待审状态的任务”，就不能把这个指标解释成“无需人工即可上线”。</p>

<h3>接入治理实践：从统一入口到成本归集</h3>

<p>在一个团队的落地实践中，Token 治理是一条独立的建设主线。第一批工作集中在三个问题：员工怎样接入，资源怎样管理，投入怎样衡量。</p>

<p>该案例首先完成了几项基础建设：</p>

<ul>
<li><strong>统一接入</strong>：验证 Coding Agent 与统一 API 入口的兼容性，搭建供团队使用的模型调用网关。</li>
<li><strong>订阅资源管理</strong>：将分散的订阅账号和接入资源纳入统一管理，明确资源归属与使用范围。</li>
<li><strong>降低配置门槛</strong>：提供一键配置脚本和安装包，让非研发用户也能快速完成工具与模型入口的配置。</li>
<li><strong>建设管理视图</strong>：扩展统一管理平台，覆盖部门、业务、项目组织管理，分业务成本统计，以及调用质量分析。</li>
</ul>


<p>这些工作解决的是规模化使用的前提：团队成员不用各自摸索配置，平台能够识别调用属于哪个业务，也能把投入放到同一口径下观察。具体资源组织方式可以根据接入条件选择，重点是让企业订阅和 API 配额的归属、用量及费用可追踪。</p>

<h3>成本、使用率与质量，要放在一起看</h3>

<p>在这类实践中，可以先手工汇总订阅与 API 费用，再推进平台自动统计，并将代码产出与费用关联观察。</p>

<p>这个指标可以帮助建立投入产出的初步视图，但还不能单独证明业务价值。如果采用代码当量，计算规则需要固定，生成代码是否被采纳、是否通过验收，以及审核和返工花了多少时间，也需要一起观察。</p>

<p>在基础统计之上，还可以按团队或任务类型分析使用覆盖、提示词质量和重复调用，帮助发现配置、上下文与流程中的问题。</p>

<p>我的理解是，Token 治理可以逐步形成三个视角：</p>

<table>
<thead>
<tr>
<th> 视角 </th>
<th> 重点观察什么 </th>
<th> 用来推动什么 </th>
</tr>
</thead>
<tbody>
<tr>
<td> 使用覆盖 </td>
<td> 哪些岗位已开始使用，哪些环节仍有接入障碍 </td>
<td> 配置支持、培训与流程接入 </td>
</tr>
<tr>
<td> 资源消耗 </td>
<td> 不同业务、项目和任务的费用与失败调用 </td>
<td> 预算分配、模型选择与调用优化 </td>
</tr>
<tr>
<td> 交付质量 </td>
<td> 调用对应的任务是否完成，是否产生返工 </td>
<td> 改进 Spec、上下文、Skill 和验证流程 </td>
</tr>
</tbody>
</table>


<p>例如，某类任务消耗很高时，应进一步区分：是任务本身复杂、重复传入大量上下文，还是需求不清导致反复重试？低使用率也需要区分：是没有适用场景，还是配置和工作流挡住了用户？热力图提供线索，任务结果才帮助我们判断原因。</p>

<p>下一步值得建设的是把调用记录与任务、PR、文档或测试报告关联起来，逐渐从“花了多少 Token”走到“完成一个合格任务花了多少总成本”。这也是 Token 治理与研发工程化真正接上的地方。</p>

<p>组织上的前提同样重要：负责人需要明确试点目标，允许团队投入时间建设规范、测试和知识资产，并安排人处理跨团队依赖。否则，一线工程师节省出来的编码时间，仍会消耗在旧流程的等待中。</p>

<h2>五. 用 Spec 明确意图，也明确人的责任</h2>

<p>当 AI 承担越来越多执行工作，需求表达中的歧义会直接影响产物。</p>

<p>“给客户分析增加一个导出功能”看起来很明确，真正实现时却会遇到一系列问题：谁有权导出？导出哪些字段？时间范围如何解释？是否包含敏感信息？大数据量如何处理？失败后能否重试？</p>

<p>这些问题需要业务和工程共同作出判断。AI 可以帮助发现遗漏、比较方案、起草规格，但不能凭空获得业务授权。</p>

<p>Spec 的价值，就在于把这些决定变成可追溯、可检查的交付依据。</p>

<p>一份可用于执行的 Spec，至少应包含：</p>

<ul>
<li>目标与非目标：本次解决什么问题，哪些内容明确不做。</li>
<li>业务规则：术语、指标口径、权限和异常场景。</li>
<li>工程约束：接口兼容性、依赖关系、性能及数据边界。</li>
<li>验收标准：什么证据能够证明任务完成。</li>
<li>待决事项：哪些问题仍需确认，由谁决定。</li>
</ul>


<p>Spec 应与代码一起版本化。需求变化时，同步调整规格、测试与实现；执行中发现矛盾时，回到决策者确认。只有这样，Spec 才能持续发挥作用。</p>

<h3>角色的变化，是责任向两端延伸</h3>

<p>工程师需要更早参与需求澄清，也需要对最终验证负责。产品和设计可以借助 AI 生成原型、探索方案、验证体验，让讨论更早建立在可观察的产物上。</p>

<p>但“一个人能做更多事”，不等于专业判断与责任自动消失。</p>

<table>
<thead>
<tr>
<th> 角色 </th>
<th> 应承担的主要责任 </th>
</tr>
</thead>
<tbody>
<tr>
<td> 产品或业务负责人 </td>
<td> 明确价值、优先级、业务规则和验收标准 </td>
</tr>
<tr>
<td> 设计负责人 </td>
<td> 明确交互、体验及可用性要求 </td>
</tr>
<tr>
<td> 工程师与技术负责人 </td>
<td> 判断架构影响、实现约束、验证方式与发布风险 </td>
</tr>
<tr>
<td> 平台团队 </td>
<td> 提供共享工具、权限控制、执行环境和成本度量 </td>
</tr>
<tr>
<td> Agent </td>
<td> 在已授权范围内规划、执行、检查，并报告异常 </td>
</tr>
</tbody>
</table>


<p>小团队可以由同一人承担多项职责，但每项决定仍应有明确负责人。</p>

<h3>测试把规格变成证据</h3>

<p>对于行为可明确验证的改动，可以先根据验收标准建立测试，确认测试能够暴露问题，再实现功能并持续回归。</p>

<p>这里需要注意：如果规格本身遗漏了场景，AI 生成的测试和代码可能一起遗漏。因此，测试通过证明的是已覆盖条件下的行为，业务验收还需要确认这些条件是否完整。</p>

<h2>六. 让 Agent 读懂项目，也让上下文保持有效</h2>

<p>到目前为止，我形成的一个判断是：<strong>AI-Native = Agent Readable。</strong></p>

<p>它强调的是一种建设视角：企业的代码、数据、规则和流程，需要能够被 Agent 理解和使用。真正落地时，还要继续追问：能否在授权范围内执行？结果能否验证？错误能否追溯？</p>

<h3>把“理解、约束、验证”沉淀为工程资产</h3>

<p><img src="https://www.rowkey.cn/images/2026-09-17-ai-native-team-delivery/agent-readable-assets-v2.png" alt="" /></p>

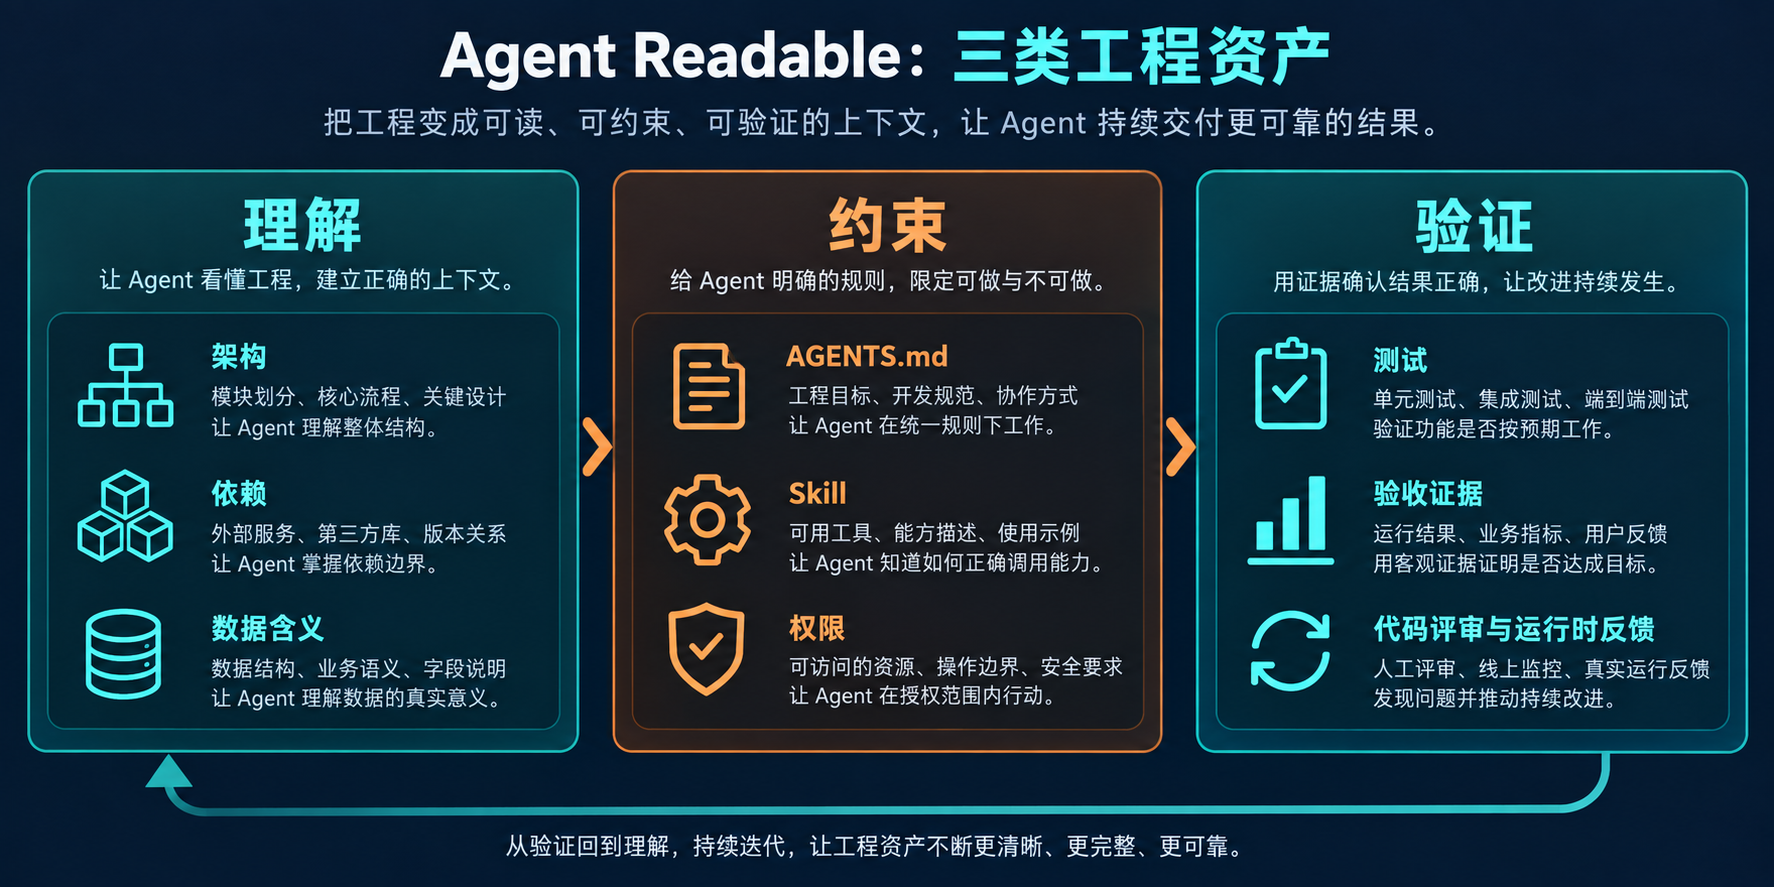
<p>每次与 AI 协作，都可以为下一次执行留下三类资产。</p>

<p><strong>理解资产</strong>回答项目为什么存在、模块如何协作、关键依赖在哪里。除了文字说明，还可以包括架构图、接口契约、代码依赖和数据口径。</p>

<p><strong>约束资产</strong>回答有哪些规则需要遵守。团队可以用 <code>AGENTS.md</code> 提供入口和关键规范，用 Skill 沉淀特定任务的流程与资源，并明确团队、项目和任务规则发生冲突时如何处理。</p>

<p><strong>验证资产</strong>回答如何判断结果正确，包括可运行的测试、验收样例、检查脚本、评审要求和运行反馈。</p>

<p>在相关工程实践中，有一种可参考的四文件组织方式：</p>

<table>
<thead>
<tr>
<th> 文件 </th>
<th> 主要内容 </th>
</tr>
</thead>
<tbody>
<tr>
<td> <code>PRODUCT.md</code> </td>
<td> 产品目标、优先级与成功标准 </td>
</tr>
<tr>
<td> <code>TECH.md</code> </td>
<td> 技术架构、关键路径与硬性约束 </td>
</tr>
<tr>
<td> <code>IMPROVEMENT.md</code> </td>
<td> 已确认的失败模式与经验 </td>
</tr>
<tr>
<td> <code>PROJECT.md</code> </td>
<td> 当前状态、关键决定与阻塞项 </td>
</tr>
</tbody>
</table>


<p>这是一种可参考的实现。已有文档体系的团队，可以保留原来的结构，重点建立清晰入口、可靠内容与更新机制，无需为了文件名再复制一套知识库。</p>

<h3>企业数据还需要语义与权限</h3>

<p>让 Agent 看见数据库表结构，并不意味着它理解业务。</p>

<p>例如，“本月收入”可能涉及退款、结算时间、币种和组织范围。SQL 能执行，也可能给出错误答案。</p>

<p>可以按任务确定查询路径：核心报表优先采用经过业务确认的查询模板；临时分析采用受语义目录、关联规则和访问策略约束的查询生成；开放探索则明确结果尚未验证。</p>

<p>模板也需要检查选择是否正确、参数是否合理，以及数据结构和口径是否发生变化。访问权限应由工具或数据服务实际执行，不能仅依赖提示词要求 Agent 自觉遵守。</p>

<h3>数据助手实践：先补业务知识，再扩大分析范围</h3>

<p>以一个处于试用阶段的数据助手案例为例，它面向业务分析场景，需要持续补充领域知识，并逐步支持原始数据层的分析。</p>

<p>在补充领域知识后，助手能够支持已知指标的查询和分析；更开放的下钻分析则需要继续验证。团队也将数据库查询能力封装为 Skill，供分析人员复用。</p>

<p>这个过程让我更明确地看到：数据助手的建设不止是接上数据库，还包括把指标定义、业务背景和分析边界整理成可复用的知识。已知指标查询跑通，只代表一部分能力成立，不能据此宣称开放分析已经成熟。</p>

<p>对数据助手而言，准确性、分析深度和等待时间需要一起评估。分析结果更详细，并不自动意味着工作体验更好；还要观察用户是否能在合理时间内拿到可用答案。</p>

<h3>知识要更新，也要允许退出</h3>

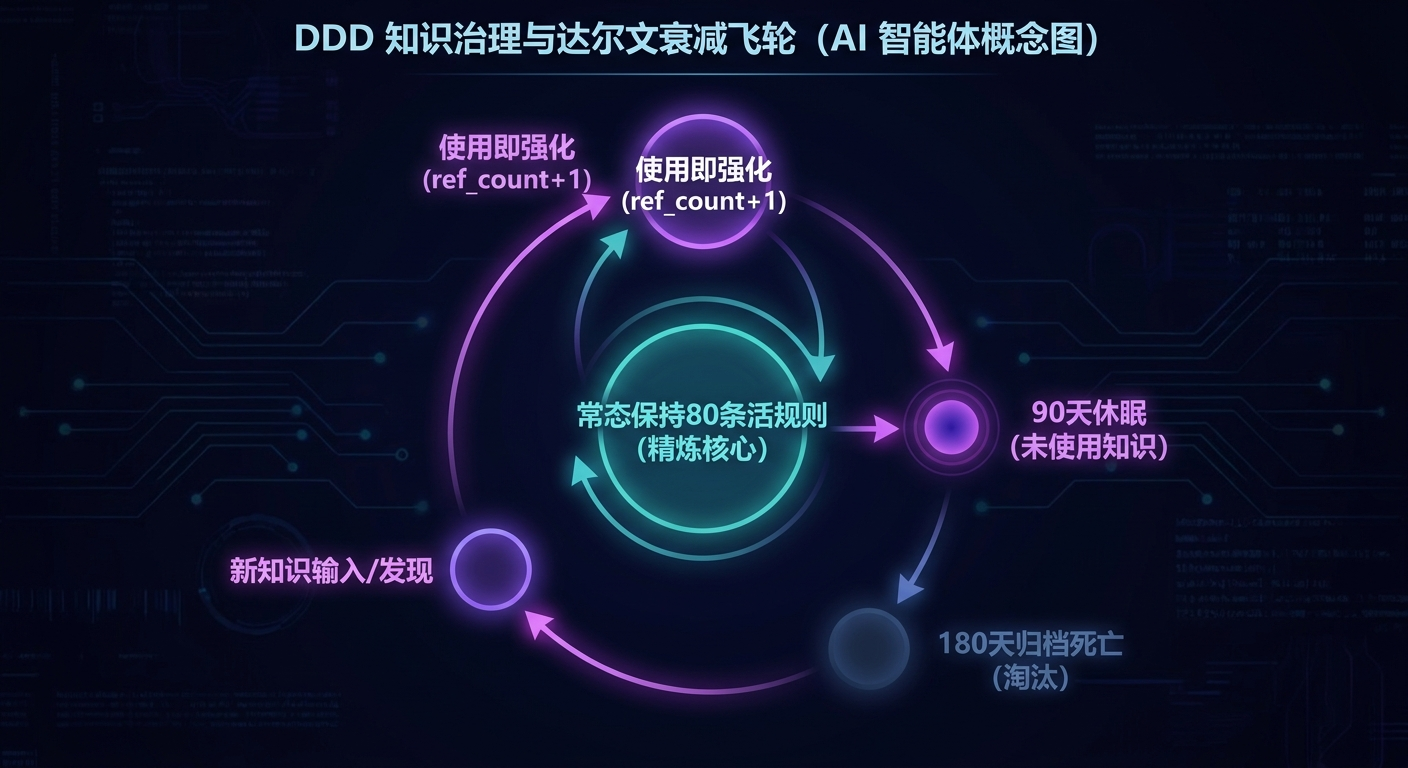
<p>部分实践用 Domain-Driven Documentation 描述这类建设，简称 DDD，即领域驱动文档。本文沿用这一命名，与通常所说的领域驱动设计区分。</p>

<p>其中值得借鉴的是知识的生命周期：从执行中发现经验，验证后沉淀，在使用中获得反馈，失效后退出活跃上下文。</p>

<p>材料中的“90 天休眠、180 天归档”是一种具体策略。实际采用时，引用频率应与规则重要性、适用版本和业务变化一起判断。灾备流程、权限边界等低频知识，不能仅因长期未被引用就失效。</p>

<p>自动化适合发现候选知识和过期迹象；影响范围大的规则，仍应经过负责人确认。归档也应保留来源与恢复路径。</p>

<h2>七. 把执行、验证和异常处理接成闭环</h2>

<p>当意图、上下文和验证方式逐渐稳定，就可以扩大 Agent 的执行范围。</p>

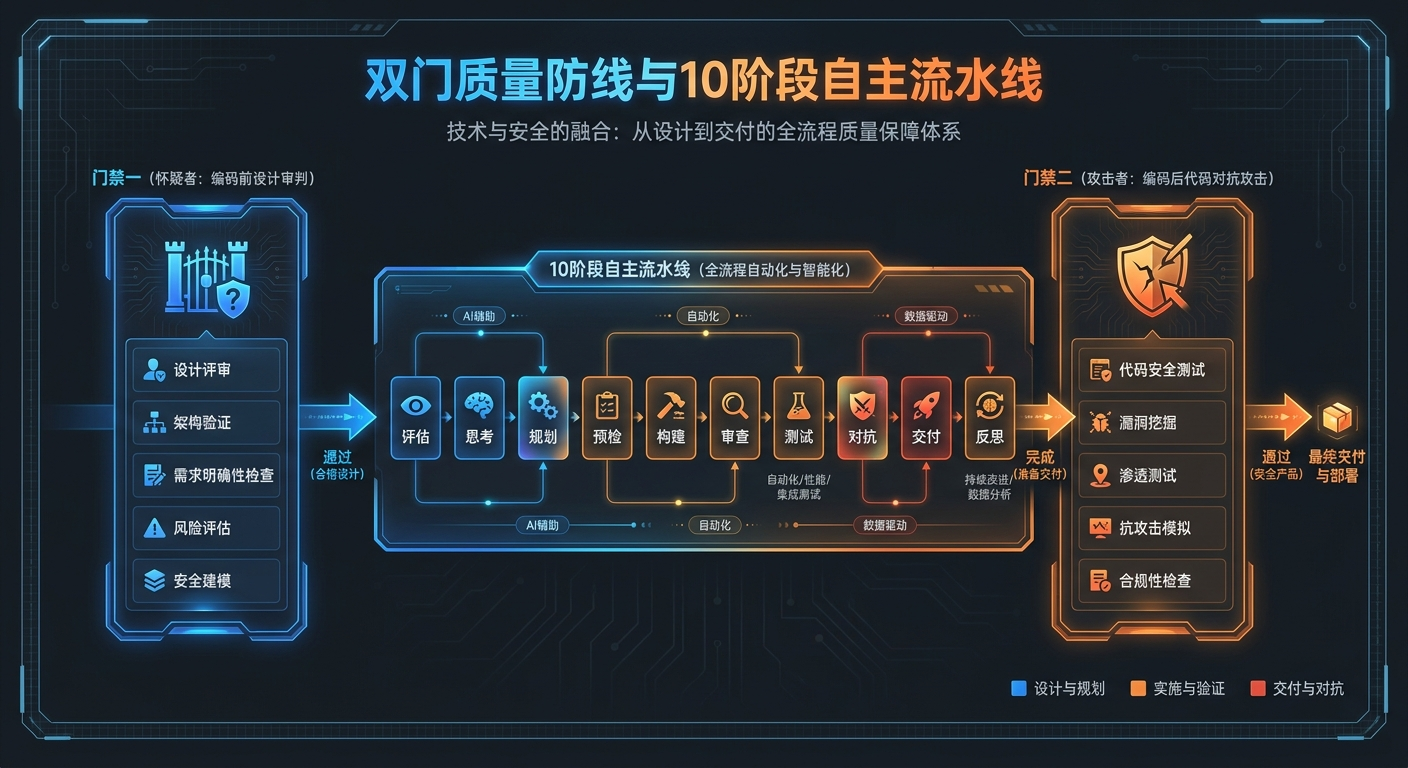
<p>一个可参考的自主流水线：评估需求、分析方案、制定计划、编码前检查、构建、审查、测试、对抗性验证、交付和反思。</p>

<p><img src="https://www.rowkey.cn/images/2026-09-17-ai-native-team-delivery/double-gate-pipeline-v2.png" alt="" /></p>

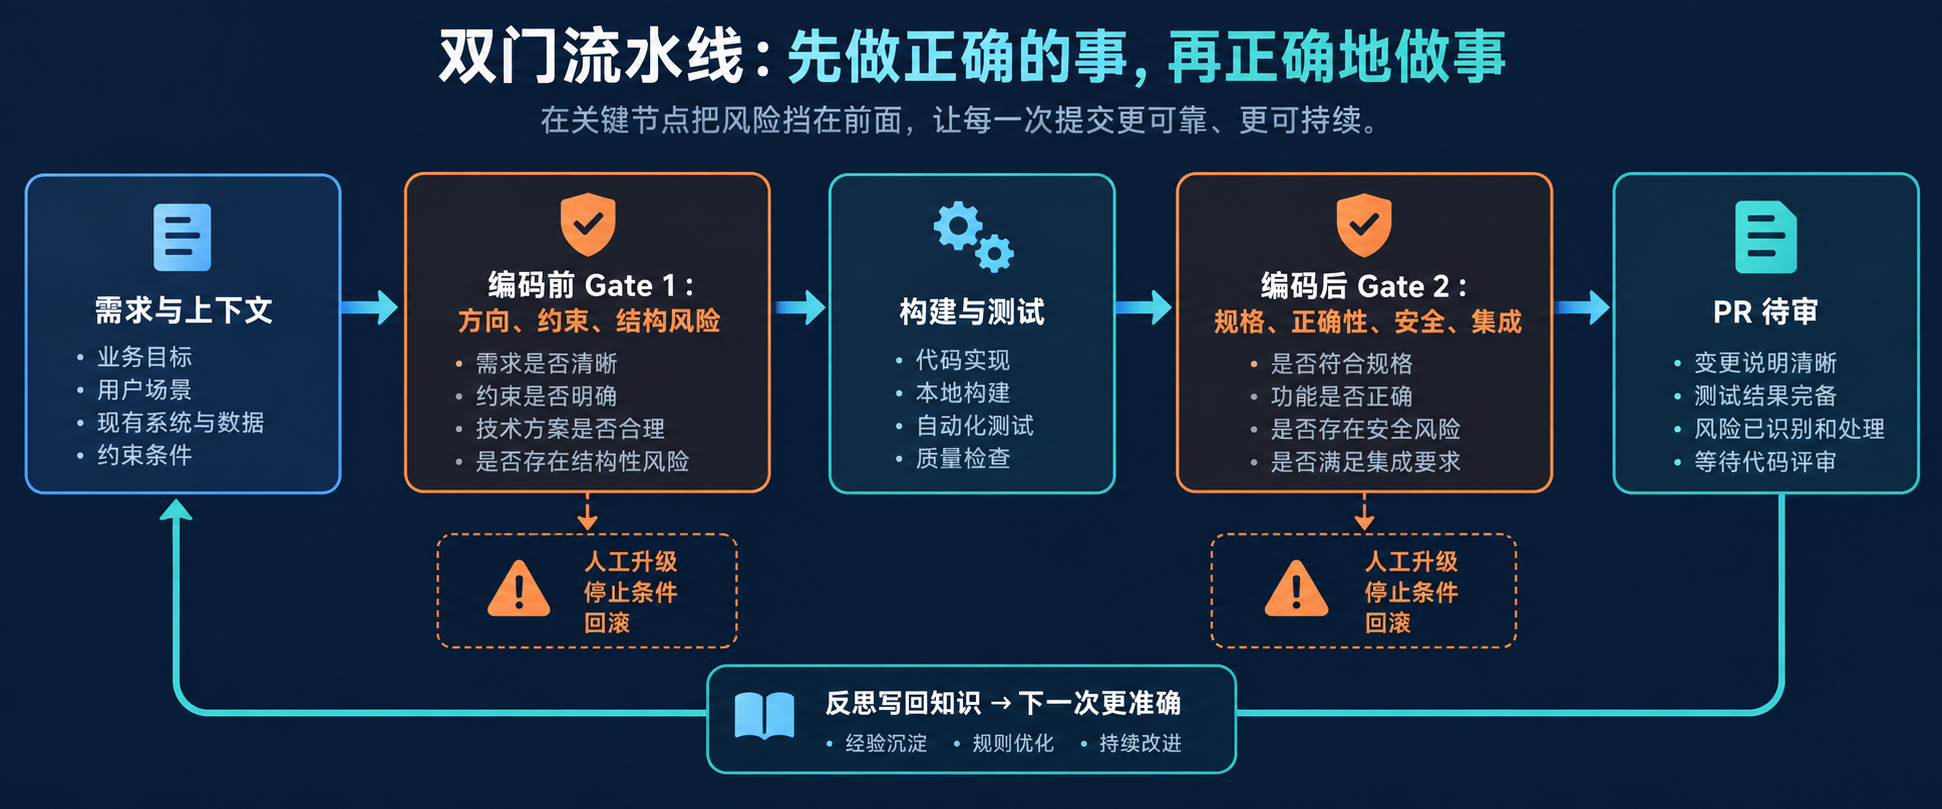
<p>这套流程最值得借鉴的，是两个不同时间点的检查。</p>

<p><strong>第一道门在编码前，检查是否值得做、方向是否正确。</strong> 审查者挑战方案中的假设、约束冲突和已知失败模式，尽量在实现之前发现偏差。</p>

<p><strong>第二道门在编码后，检查实际产物是否满足要求。</strong> 审查者以改动和验收证据为依据，检查正确性、兼容性、安全及系统影响。</p>

<p>第二道门可以使用独立上下文，减少对实现者解释的依赖，但仍应允许读取必要的规格、调用方和测试。独立审查的目的，是形成独立判断。</p>

<p>两个 Agent 也可能有相似盲点，因此还需要自动化测试、静态检查、运行证据和必要的人工验收共同支撑结论。</p>

<h3>自主执行必须定义什么时候停下来</h3>

<p>一个可运行的闭环，除了成功路径，还需要明确：</p>

<ul>
<li>需求或权限不清楚时，向谁升级。</li>
<li>连续验证失败时，最多重试多少轮。</li>
<li>时间或费用达到上限时，如何停止并交接。</li>
<li>涉及高影响变更时，在哪个节点由人决定。</li>
<li>执行失败后，如何保留现场、恢复状态或回滚。</li>
</ul>


<p>任务类型也会影响流程。“完成一个导出功能”主要按产物和验收标准判断；“把接口延迟降低到目标范围”则需要反复测量，直到外部指标达标或触发停止条件。</p>

<p>PR 待审、允许合并和允许生产发布，应分别设置完成条件与授权边界。</p>

<h3>埋点校验实践：上线以后，继续和人工结果对照</h3>

<p>在一个自动化校验案例中，Agent 被用于检查埋点是否符合要求。投入实际使用后，团队继续将 Agent 结果与人工结果对照，在版本变化中发现问题并优化。</p>

<p>这类任务除了检查规则，还需要关注任务引导、执行时长、失败恢复和结果留存，才能适应持续变化的测试场景。</p>

<p>这类实践的价值在于把验证落到了真实工作中。Agent 能运行一次，不代表能稳定覆盖不同版本和长任务；接下来应持续记录漏检、误报、人工复核成本和任务完成情况，再决定扩大哪些测试范围。这些是建议继续追踪的指标，并非已经测得的收益。</p>

<h3>用一个需求贯穿整个流程</h3>

<p>仍以“客户分析导出”为例，下面是一个示意流程，并非已验证的项目案例：</p>

<ol>
<li>产品明确导出对象、字段和验收场景，工程师确认权限、数据量与接口约束。</li>
<li>Agent 读取 Spec、数据目录和现有实现，提出改动计划。</li>
<li>编码前审查发现“是否允许跨部门导出”尚未确定，任务暂停，由业务负责人确认。</li>
<li>边界明确后，Agent 建立权限、空数据、边界日期等测试，再完成实现。</li>
<li>编码后审查结合调用链和运行结果检查改动，通过后输出 PR、测试证据和剩余风险。</li>
<li>经确认的新经验写回项目知识，并补充可持续运行的验证。</li>
</ol>


<p>这个过程的价值，在于问题更早暴露，执行更少反复，同类任务下次有可靠依据可用。</p>

<h2>八. 从一条流水线，走向团队共享的能力</h2>

<p>当多个任务开始复用同一套知识、工具和验证流程，企业会需要更统一的能力管理方式。</p>

<p>可以把它理解为三类能力的协作：</p>

<ul>
<li><strong>运行与控制能力</strong>：执行环境、工具接入、任务调度、权限、预算和审计。</li>
<li><strong>领域知识能力</strong>：业务规则、项目约束、代码与数据上下文，以及经过验证的经验。</li>
<li><strong>交付能力</strong>：面向研发、分析、内容或其他业务的工作流与产物。</li>
</ul>


<p>这些能力未必需要从头开发。企业更应明确哪些可以使用现有平台，哪些是需要自己长期维护的领域资产。</p>

<p>在组织分工上，可以借鉴 Builder、Hub、Runner 的思路：建设团队沉淀共享知识与工具；共享平台管理版本、权限和分发；面向用户的 Agent 或应用组合这些能力，完成具体任务。</p>

<p>团队积累的效果，应能体现为新人更快上手、重复错误减少、同类任务交付更稳定。仅仅增加文档或 Skill 数量，无法证明能力已经提升。</p>

<h3>Agent 在群里，但工作不能只留在聊天里</h3>

<p>在业务落地上，我倾向于优先尝试现有办公 IM。员工已经在群里讨论问题、分配任务和确认结果，让 Agent 进入已有协作环境，可以降低使用门槛。</p>

<p>后台系统提供受控的 MCP 或 CLI 能力，业务流程沉淀为 Skill，员工在群里发起任务和处理异常。这是一条值得试验的路径。</p>

<p>在群聊接入实践中，可以先验证单人 @Agent 发起任务的链路，再逐步扩展多人协作。“机器人能在群里响应”与“能够理解群内分工并持续推进任务”，需要分开建设和验收。</p>

<p>客服类 Agent 则适合先在有限场景中灰度验证，根据回答质量、转人工情况和用户反馈逐步扩大范围。不同 Agent 应根据业务风险和验证结果分别确定推进节奏。</p>

<p>但聊天入口还需要连接可追踪的任务状态、产物、责任人和执行记录。复杂数据分析、设计评审或高密度操作，也可能更适合专门界面。入口可以不同，背后的知识、权限和交付机制应尽量复用。</p>

<h2>九. Vibe Coding 实践：用脚手架固化从理解到验收的链路</h2>

<p>前面讨论了意图、上下文、执行验证与团队复用。回到 AI-Native 产研这条落地线，项目脚手架可以把这些能力串成日常交付流程。</p>

<p>在一份 Vibe Coding 工程化实践中，建设重点贯穿开发、交付和测试：让 Agent 理解项目，用 Spec 对齐需求，再把测试、独立评审和人工验收接起来。配套脚手架提供了一个具体载体，可用于新项目初始化，也可用于已有项目改造。</p>

<p><strong>第一步，先建立项目事实。</strong> 新项目先确认最小必要信息；已有项目先盘点代码、配置与测试，整理架构、模块依赖和外部依赖。存在接口或持久化数据时，再补接口清单、数据模型与关系图。Agent 后续从这些材料进入项目，也能沿索引回到代码核实，减少每次从聊天重新解释项目的成本。改造已有仓库时先检查冲突，再合并规范，保留原有文档和用户修改。</p>

<p><strong>第二步，把规则和任务流程分开维护。</strong> <code>AGENTS.md</code> 提供入口，Rules 区分通用底线、团队规范和项目约束，Skill 承载测试、接口对齐、评审等可复用流程，并按任务适用性加载。一次需求中的临时要求不必全部上升为团队规则；反复出现且经确认的问题，才值得沉淀为共享约束。</p>

<p><strong>第三步，让 Spec 成为需求与验收的共同依据。</strong> 脚手架采用开源项目 OpenSpec 管理提案、设计、规格场景和任务；以一个 Change 表达一项可独立交付、验收的需求。实现与测试围绕同一份任务台账推进，避免规划工具和执行工具各维护一套状态。边界明确、低风险且不改变产品行为的小修可以简化流程；需求、接口或验收边界变化时，则先更新规格。</p>

<p><strong>第四步，让评审结论对应实际交付版本。</strong> 实现者先自查并运行适用测试，再由未参与实现的 Coding Agent 独立评审。脚手架要求留下审查范围、上下文与文件指纹；代码或相关上下文发生实质变化，旧结论就不能直接沿用。选择本地运行态联调时，还要启动真实目标、执行关键场景并记录证据；环境不可用要明确报告阻塞，不能写成通过。人工审查应优先关注高影响变更和测试本身，并保留合并决策。</p>

<p><strong>第五步，把“研发交付”和“产品验收”分开。</strong> 交付文档需要把需求场景、任务、实现位置和验证证据逐项对应，并写清版本、风险、回滚方式和下一位负责人的动作。研发完成只代表进入待验收状态。产品验收后，再复盘哪些问题属于项目知识、团队规则或可复用流程，经人工确认后安排沉淀。</p>

<p>例如，一项导出需求的交付记录，可以把“无权限用户无法导出”对应到具体任务、权限校验实现和可重复运行的测试。验收者据此检查行为；如果验收发现字段口径遗漏，就回到规格与测试一起修正。这是上述机制的示意用法，不是额外宣称一个已验证案例。</p>

<h3>基于钉钉群的需求流转：让下一位负责人接得住</h3>

<p>上述链路还需要解决一个日常问题：规格准备好了，谁开始开发？研发交付了，谁来验收？脚手架为此提供钉钉项目群集成，将 OpenSpec Change 的状态变化与群内负责人提醒连接起来。</p>

<p><strong>规格与交付证据保存在 Git 中，钉钉群负责把交接信息送到下一位负责人。</strong> 配置完成后，提交后的通知脚本检查需求工件和任务状态变化，按需求涉及的模块找到产品或研发负责人，在群里定向 @。它所支持的交接过程如下：</p>

<table>
<thead>
<tr>
<th> 节点 </th>
<th> 触发依据 </th>
<th> 群内交接 </th>
</tr>
</thead>
<tbody>
<tr>
<td> 需求就绪或规格更新 </td>
<td> 规划工件齐备、严格校验通过，且相关规划内容新增或更新 </td>
<td> 提醒研发负责人确认并实施需求 </td>
</tr>
<tr>
<td> 研发交付、待产品验收 </td>
<td> 交付状态有效，具备实现版本与交付文档，且没有影响交付的待决事项 </td>
<td> 提醒产品负责人，提供交付摘要、版本、文档路径、下一步与完成标准 </td>
</tr>
<tr>
<td> 产品验收 </td>
<td> 产品负责人依据场景验收，并记录验收状态 </td>
<td> 单独记录验收时不另发通知；验收结论保留在需求记录中 </td>
</tr>
<tr>
<td> 验收后归档 </td>
<td> 完成相关任务、验收与复盘，同步相关主规格并归档需求 </td>
<td> 通知研发负责人该需求已验收并归档 </td>
</tr>
</tbody>
</table>


<p>以导出需求为例，产品与工程确认范围后提交规格，群里提醒研发接手；研发完成实现、测试和评审，提交交付材料，群里再提醒产品按清单验收。验收发现偏差时，应回到需求记录中修正规格、实现或证据；完成验收、复盘与归档后，再向研发反馈结果。群里的讨论因此能够落回同一项需求，而不是散落成几段无法追踪的聊天。</p>

<p>这套机制围绕交接节点通知，普通任务进度变化不会逐条刷屏。交付证据缺失或仍有影响交付的待决事项时，不发送待验收通知。通知是否送达与需求是否交付是两件事：通知配置缺失或发送失败，不能据此改写仓库中的交付事实，也不能把“已经 @ 了负责人”当作对方已经验收。</p>

<p>这也补上了团队复用中的协作环节：<strong>不仅把流程交给 Agent 执行，还把结果、责任和下一步交到具体的人手上。</strong> 这里描述的是脚手架提供的流转机制，其运行效果仍需在实际项目中观察。</p>

<p>这套实践最值得借鉴的是：<strong>每次交付都留下可核对的证据，每次验收都为下一次协作提供改进依据。</strong> 文档和脚手架能够说明机制如何设计，实际能否缩短交付周期、减少返工，还需要在日常需求中持续衡量。云端编码控制平面、隔离执行和测试 Agent 的扩展，可作为后续方向，不能仅凭建设计划就视为成熟能力。</p>

<h2>十. 先跑通一个试点，再扩大自主范围</h2>

<p>企业无需等整套体系齐备，才开始验证价值。</p>

<p>可以先选择一个依赖相对清楚、验收能够执行的仓库，以及一类边界明确的任务，用一个月左右的试点观察变化。这个周期用于学习与比较，不是收益承诺。</p>

<p>试点按四件事推进：</p>

<ol>
<li><strong>记录现状</strong>：确定任务范围、责任人和交付质量基线。</li>
<li><strong>补齐基础</strong>：建立 Spec、上下文入口、测试与关键权限边界。</li>
<li><strong>连接闭环</strong>：引入编码前后检查，明确人工升级和停止条件。</li>
<li><strong>评估与复用</strong>：比较同类任务的周期、质量和总成本，把有效经验复制到下一类任务。</li>
</ol>


<p>如果审核和返工成本持续上升，就先缩小任务范围，找出规格、上下文或验证中的缺口。只有收益和质量得到验证，再逐步扩大自主执行权限。</p>

<p>我认为，AI-Native 最值得追求的变化，是把个人与 AI 协作时形成的判断、约束和经验，转化成团队可使用、可检查、可更新的能力。</p>

<p>代码生成只是其中一个环节。企业最终需要回答的是：<strong>下一次遇到类似需求，我们能否更少依赖临时解释，更早发现错误，并以更低的总成本交付可信的结果？</strong></p>

<hr />

<p>说明：本文结合行业分享与团队实践整理。案例已匿名化，省略企业与产品名称、内部工具组合、具体排期及部署状态，保留工程方法与实践边界；建议和示意流程不作为已验证成果。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[重构产研与组织：企业级 AI-Native 落地全景图与演进四部曲]]></title>
    <link href="https://www.rowkey.cn/blog/2026/09/02/ai-native-evolution-agentic-os/"/>
    <updated>2026-09-02T12:30:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/09/02/ai-native-evolution-agentic-os</id>
    <content type="html"><![CDATA[<h2>引言：从“局部提效”到“系统级重构”</h2>

<p>随着 Cursor、GitHub Copilot、Codex 等 AI 编码工具在研发团队中的全面渗透，许多团队发现了一个残酷的现实：<strong>41% 的代码已经由 AI 生成，但顶尖团队与普通团队的效能差距却被拉大了 100%～150%</strong>。单纯提升编码速度，并没有让项目交付同步变快。</p>

<p>原因很简单：编码仅占软件全生命周期的 30% 左右。当 AI 把写代码的时间压缩了 80%，上游需求不清晰带来的返工更快了，未经验证的设计决策堆积更快了，下游测试与发布的瓶颈被放大得更加明显。</p>

<p>如果仅仅把大模型当作“高级 Copilot”或“高效打字机”，企业的 AI 化就会止步于个人单点提效，甚至陷入“局部正确、全局混乱”的陷阱。</p>

<!-- more -->


<h3>生产力演进的三重境界</h3>

<p>企业在推进 AI 落地时，生产力的提升通常呈现出三个递进阶段：</p>

<ul>
<li><p><strong>第一阶段（+30% 生产力）</strong>：AI-Assistant / Copilot 模式。人仍然在主驾驶位置，AI 坐在旁边提供协助，主要解决单点编码与补全问题。</p></li>
<li><p><strong>第二阶段（5～10 倍能力放大）</strong>：一人全栈化。AI 成为全栈能力放大器，打破传统岗位边界，让单个工程师能够同时高效处理产品、需求、研发、测试与运维等跨领域任务。</p></li>
<li><p><strong>第三阶段（Human-on-the-Loop 自动化）</strong>：构建自主运行系统。AI 和 Agent 在系统中传递信息、分析问题、推动任务和生成代码，人类不再卡在每一个执行节点，而是在关键位置进行监督、审核与判断。</p></li>
</ul>


<p>真正的 <strong>AI-Native 转型</strong>，核心等式在于 <strong><code>AI-Native = Agent Readable</code></strong>。从“人用 AI 提效”走向“Human Directs, AI Delivers（人定方向，AI 交付）”，最终建立基于 <strong>Agentic OS</strong> 的系统级复利。</p>

<p><img src="https://www.rowkey.cn/images/ai-native-architecture-zh.png" alt="" /></p>

<hr />

<h2>一、 第一阶段：基建与契约 —— Token 治理与 Spec 驱动</h2>

<p>在转型的初始阶段，大多数团队面临的是“工具散乱、效果难衡量、成本不可控”的问题。要实现“人把控、AI 实现”的协同，首先必须打牢两块基石：<strong>Token 治理</strong> 与 <strong>Spec-Driven 交付</strong>。</p>

<h3>1.1 Token 基座：网关、号池与质量监控</h3>

<p>没有 Token 治理，就无法谈及规模化的 AI 落地。Token 治理不仅是成本控制手段，更是推进全员 AI 使用率与评估交付质量的指标中枢。</p>

<p>Token 基座的建设包含三个维度：</p>

<ul>
<li><p><strong>Token 网关与号池管理</strong>：统一提供 API 中转、路由分发、计费管理与多账号号池（如绑定多 IP/AWS 主机），保障多 Agent 并发下的基础设施稳定性。</p></li>
<li><p><strong>渗透率与使用率监控</strong>：监控各部门、各岗位的 Token 消耗与活跃度，精准识别阻碍 AI 普及的断点。</p></li>
<li><p><strong>交付质量与 ROI 评估</strong>：将 Token 消耗与真实的产物（代码提交、PR、文档、测试用例）绑定，评估单位 Token 创造的实际业务价值，防止无意义的 Prompt 试错。</p></li>
</ul>


<h3>1.2 Spec-Driven 交付：人与 Agent 的“数字契约”</h3>

<p>在传统研发流程中，需求往往通过口头沟通或模糊的文档传递。当执行主体由人类工程师转变为 AI 时，这种模糊性会导致严重的方向漂移。</p>

<p><strong>工程师角色的根本转变</strong>：
过去的工程师是“写代码的人”；<strong>AI 时代/Spec 时代的工程师是“定义意图的人 + 验证质量的人”</strong>。AI 负责上下文管理、过程追溯和模板执行，人负责数据建模决策、指标口径判定和复杂业务翻译。</p>

<p>Spec（规格说明书）是人与 AI 协作的“数字合同”，也是全链路的唯一锚点：</p>

<ul>
<li><p><strong>SDD（Spec-Driven Development）</strong>：通过 OpenSpec 锁定意图。上游所有决策（产品、设计、架构）都服务于写好 Spec。</p></li>
<li><p><strong>TDD（Test-Driven Development）</strong>：在下游作为验收机制。先根据 Spec 生成测试用例（Red），再生成代码实现（Green），最后进行二进制验证（Verify）。</p></li>
</ul>


<hr />

<h2>二、 第二阶段：上下文与认知 —— Agent Readable 与三层工程资产</h2>

<p>有了 Spec 之后，虽然消除了意图漂移，但 Agent 在执行时常常遇到“导航盲区”：不了解代码库历史、不懂业务逻辑、看不懂数据库字段含义。第二阶段的核心任务是打造 <strong>Agent Readable</strong> 的基础设施，并沉淀可持续积累的三层工程资产。</p>

<h3>2.1 理解、约束、验证：打造可持续积累的工程资产</h3>

<p>稳定使用 AI 的工程师，每次与 AI 协作都在同时为三层工程资产添砖加瓦；而混乱使用 AI 的工程师，每次都是从零开始，一次性用完就扔：</p>

<ul>
<li><p><strong>理解层（Understand）</strong>：通过架构图锚定系统级共识、通过模块图暴露代码级依赖、通过依赖图展示生态级牵挂，让 Agent 快速看懂系统全貌。</p></li>
<li><p><strong>约束层（Constrain）</strong>：</p>

<ul>
<li><p><strong><code>AGENTS.md</code></strong>：定标准，告诉 AI 这是什么项目、遵守什么规范，是静态知识。</p></li>
<li><p><strong><code>Skill</code></strong>：定流程，告诉 AI 怎么做特定的事情，是动态能力。</p></li>
</ul>
</li>
<li><p><strong>验证层（Verify）</strong>：建立质量保障体系，识别核心链路、划定测试边界、制定 Review 策略，并接入 CI/CD 与 AI 可观测性工具（如 LangSmith、Langfuse）。</p></li>
</ul>


<h3>2.2 让代码与数据对 Agent 可读（Agent Readable）</h3>

<p>要让 Agent 自主做出正确判断，必须将代码和企业数据改造为“AI 易读”的结构：</p>

<h4>1) Code 的 Agent Readable：AI-Ready Repo</h4>

<p>代码仓库必须显式提供上下文，让 AI 理解“项目为什么存在、怎么运行、踩过什么坑、当前处于什么状态”。建议在仓库中标准化以下四类文件：</p>

<ul>
<li><p><code>PRODUCT.md</code>：记录产品目标、业务优先级与成功标准。</p></li>
<li><p><code>TECH.md</code>：记录技术架构、硬性约束（Blocking Constraints）与关键路径。</p></li>
<li><p><code>IMPROVEMENT.md</code>：记录历史教训、避坑指南与踩坑反馈。</p></li>
<li><p><code>PROJECT.md</code>：记录当前迭代状态、关键决策与阻塞项。</p></li>
</ul>


<h4>2) Data 的 Agent Readable：Agent for Data</h4>

<p>直接将自然语言交给大模型生成 SQL（裸 NL2SQL）的准确率通常仅为 60%-70%，在生产环境中几乎不可用。其根本原因在于缺少“数据含义与访问权限”的语义合约。必须建立三层数据准确度模型：</p>

<ul>
<li><p><strong>Level 1: Certified Patterns（100% 准确）</strong>：预置经过验证的 SQL 模板，Agent 仅做参数替换与模板选择。适用于核心报表、合规推送。</p></li>
<li><p><strong>Level 2: Guided NL2SQL（~95% 准确）</strong>：NL2SQL + Catalog 语义约束（白名单 + 强制过滤 + JOIN 映射规则）。适用于临时分析与自助探索。</p></li>
<li><p><strong>Level 3: Unconstrained NL2SQL（60%-70% 准确）</strong>：无约束自由生成，仅建议作为探索参考。</p></li>
</ul>


<h3>2.3 DDD 知识治理：让领域知识“自己活着”</h3>

<p>这里的 <strong>DDD 指的是 Domain-Driven Documentation（领域驱动文档）</strong>，而非传统的 Domain-Driven Design。</p>

<p><img src="https://www.rowkey.cn/images/ddd-knowledge-decay-zh.png" alt="" /></p>

<p>传统知识库的最大问题是“维护税大于查询价值”——知识不断堆积，最终沦为垃圾场。AI 时代的知识治理，核心竞争力不是“记住”，而是<strong>“遗忘”</strong>：</p>

<ul>
<li><p><strong>达尔文衰减模式</strong>：知识被引用则强化（<code>ref_count + 1</code>）；90 天无引用进入休眠（Dormant）；180 天无引用自动归档死亡（Archived）。由衰减引擎每日自动执行，保持知识库的高精炼度（常态维持 80-100 条核心活规则）。</p></li>
<li><p><strong>三条治理原则</strong>：</p>

<ul>
<li><p><strong>自动生成</strong>：引擎从代码、数据与执行日志中自动提取，人类仅做审核补充。</p></li>
<li><p><strong>自动衰减</strong>：依靠系统机制剔除过时知识，无需定期人工 Review。</p></li>
<li><p><strong>自动复利</strong>：使用越多，知识网图越丰富，推荐越精准，形成知识飞轮。</p></li>
</ul>
</li>
</ul>


<hr />

<h2>三、 第三阶段：流程闭环 —— Autonomous Pipeline 与 6 个效能杠杆</h2>

<p>当代码与数据实现 Agent Readable、且领域知识具备自我演进能力后，研发流程便可迈入全自动化阶段：<strong>Autonomous Pipeline（自主流水线）</strong>。</p>

<h3>3.1 10 阶段闭环流水线</h3>

<p>Autonomous Pipeline 将编码视为黑盒（Coding as Black Box），实现“一句话需求 → PR-Ready”的闭环。其典型执行链路包含 10 个阶段：</p>

<figure class='code'><div class="highlight"><table><tr><td class="gutter"><pre class="line-numbers"><span class='line-number'>1</span>
</pre></td><td class='code'><pre><code class=''><span class='line'>EVALUATE → THINK → PLAN → PRE-CHECK → BUILD → REVIEW → TEST → ADVERSARIAL → DELIVER → REFLECT</span></code></pre></td></tr></table></div></figure>


<h3>3.2 双门架构（Double-Gate Architecture）</h3>

<p>为确保全自动流水线不输出垃圾代码，系统引入了两个独立的 Sub-Agent 质量门：</p>

<p><img src="https://www.rowkey.cn/images/double-gate-architecture-zh.png" alt="" /></p>

<ul>
<li><p><strong>Gate 1：做正确的事（编码前）</strong></p>

<ul>
<li>由“怀疑者”角色（独立上下文 Sub-Agent）在 <code>BUILD</code> 之前挑战方案。</li>
<li>检查方向对齐、约束违规及已知失败模式（<code>IMPROVEMENT.md</code>），在代码未写前拦截方向错误。</li>
</ul>
</li>
<li><p><strong>Gate 2：正确地做事（编码后）</strong></p>

<ul>
<li>由“攻击者”角色（独立上下文 Sub-Agent）直接攻击 ChangeSet（只看 git diff，忽略 Builder 的主观意图）。</li>
<li>针对正确性、安全性、集成度进行 30+ 项 Review Pattern 检查，发现隐蔽 Bug。</li>
</ul>
</li>
</ul>


<h3>3.3 拉开研发效能差距的 6 个杠杆</h3>

<p>在自动化流水线之上，团队还需要通过以下 6 个工程杠杆防范返工：</p>

<ul>
<li><p><strong>智能自动化</strong>：将重复、易错、无聊的工作（如打包、日志排查、重复测试）交给流水线，守护高价值思考时间。</p></li>
<li><p><strong>设计优先原则</strong>：编码前强制设计环节，AI 辅助头脑风暴，但不代替人类决策。</p></li>
<li><p><strong>维护心流状态</strong>：保护深度工作时间，减少被打断频次。</p></li>
<li><p><strong>降低认知负荷</strong>：减少频繁的上下文切换，精简非必要会议。</p></li>
<li><p><strong>持续学习成长</strong>：实行教学式代码评审与配对编程。</p></li>
<li><p><strong>优化工具链</strong>：选择现代化工具，减少技术债务，让工具“隐身”。</p></li>
</ul>


<hr />

<h2>四、 第四阶段：协同与终局 —— 业务 AI Native 与 Agentic OS</h2>

<p>有了强大的 Harness、Runtime 与 Pipeline 之后，Agent 应该在哪里与人类协同？</p>

<h3>4.1 不要造新的工作台，办公 IM 才是 Agent 自然协同终局</h3>

<p>很多企业在推动 AI 落地时，第一反应是去开发一个新的 Web Portal 或独立 App。然而，<strong>员工并不需要第 101 个独立系统</strong>。</p>

<p>钉钉、飞书、企业微信等办公 IM 群聊，是企业内员工信息交换最频繁、最自然的场所：</p>

<ul>
<li><p><strong>系统能力 MCP/CLI 化</strong>：后台业务系统的能力全部暴露为 MCP 服务或 CLI 工具。</p></li>
<li><p><strong>业务沉淀 Skill</strong>：将业务 SOP 和岗位经验沉淀为可被 Agent 调用的 Skill。</p></li>
<li><p><strong>Agent 在群里</strong>：Agent 作为机器人直接拉入业务或研发群聊，人类直接 @它分发任务，推理过程与结果在群内透明展示。</p></li>
</ul>


<h3>4.2 Agentic OS 的三层解耦架构</h3>

<p>AI-Native 转型的终局，是构建一套以系统形态自主运行的 <strong>Agentic OS</strong>：</p>

<ul>
<li><p><strong>底盘（Harness / Runtime）</strong>：提供执行能力（Capability），包括运行环境、Tool/MCP 接入、调度器、Hook 与渠道适配器。底盘决定 Agent“能做什么”，但不决定“该做什么”。</p></li>
<li><p><strong>大脑（DDD Knowledge Layer）</strong>：提供判断力（Judgment），包含 4-Docs 领域知识、代码图谱、数据 Catalog 与演化反馈。</p></li>
<li><p><strong>手脚（AgentHub / Delivery Engines）</strong>：提供交付形态，面向不同业务场景导出 Agent 服务（如 CLI、IM 机器人、Web 交互终端）。</p></li>
</ul>


<h3>4.3 角色重塑与系统级复利</h3>

<p>在 Agentic OS 架构下，团队成员的分工实现了彻底重塑：</p>

<ul>
<li><p><strong>AI 职能人员</strong>：专注于编写 Skill、MCP 接口以及沉淀领域知识，为系统补充“大脑”与“手脚”。</p></li>
<li><p><strong>AgentHub</strong>：调度各种专有 Skill 与 Agent，基于 Runtime 机制为企业内外提供全自动化的 Agent 服务。</p></li>
</ul>


<p>系统每运行一次，<code>REFLECT</code> 机制都会将错误教训与新经验写回知识层，使下一次执行更精准，真正实现<strong>“越用越聪明”的系统级复利</strong>。</p>

<hr />

<h2>总结：避开“跳层”的陷阱</h2>

<p>在推进 AI-Native 转型的过程中，切忌盲目跨越阶段：</p>

<ul>
<li><p><strong>直接跨到 Autonomous Pipeline 而缺失 DDD</strong>：Agent 虽有强执行力，但处于“盲干”状态。</p></li>
<li><p><strong>有 DDD 但缺乏 Spec 纪律</strong>：知识丰富，但缺乏约束，导致“意图漂移”。</p></li>
<li><p><strong>有自主执行但缺乏反馈飞轮</strong>：第 300 天的交付质量依然和第 1 天一样。</p></li>
</ul>


<p>从 <strong>Token 治理</strong> 到 <strong>Spec-Driven</strong>，再到 <strong>Agent Readable</strong>、<strong>Autonomous Pipeline</strong>，最终抵达 <strong>Agentic OS</strong>，这是一条清晰而严谨的工程演进之路。只有一步一个脚印搭建好知识与控制面，才能真正释放 AI 在企业级生产中的终极价值。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[DeepSeek Harness 与 AgentScope Java 深度对比：两条不同的 Agent 工程化路线]]></title>
    <link href="https://www.rowkey.cn/blog/2026/08/21/deepseek-harness-vs-agentscope-java/"/>
    <updated>2026-08-21T00:10:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/08/21/deepseek-harness-vs-agentscope-java</id>
    <content type="html"><![CDATA[<p>最近深度读了两个很有代表性的 Agent 项目：</p>

<ul>
<li><a href="https://github.com/deepseek-ai/deepseek-harness">DeepSeek Harness</a></li>
<li><a href="https://github.com/agentscope-ai/agentscope-java">AgentScope Java</a></li>
</ul>


<p>它们都在解决同一个问题：<strong>怎样把“大模型 + 工具调用”变成一个能够长期运行、可以恢复、可扩展、可治理的 Agent 系统。</strong></p>

<p>但读完代码后，我发现它们其实不在同一条赛道上。</p>

<p>DeepSeek Harness 更像一套为 Coding Agent 产品准备的<strong>可组合运行时内核</strong>；AgentScope Java 更像一套面向 Java 企业应用的<strong>Agent 框架、Harness 与服务平台</strong>。</p>

<p>如果只看 README，容易得出“两个项目功能差不多，只是一个用 TypeScript、一个用 Java”的结论。真正进入源码后，会看到两套完全不同的架构取向：</p>

<ul>
<li>DeepSeek Harness 把重点放在运行时语义：插件生命周期、事件溯源、精确回放、工具执行流水线、能力替换</li>
<li>AgentScope Java 把重点放在生产运行：多租户状态、分布式恢复、长期记忆、沙箱、渠道接入和统一控制面</li>
</ul>


<p>先说我的结论：</p>

<blockquote><p><strong>如果你想造一个 Coding Agent 产品，或者深度定制 Agent Runtime，DeepSeek Harness 更值得研究；如果你想把 Agent 纳入现有 Java 企业系统，并进一步做成可运营的服务，AgentScope Java 路线更直接。</strong></p></blockquote>

<!-- more -->


<h2>一、先别急着比功能：它们不是同一层级的产品</h2>

<p>在讨论这两个项目之前，先要回答一个基础问题：什么是 Harness？</p>

<p>一个最简单的 Agent 循环通常只有几步：</p>

<ol>
<li>把历史消息和工具描述发给模型</li>
<li>模型决定回复，或者调用工具</li>
<li>执行工具，把结果放回上下文</li>
<li>继续循环，直到输出最终答案</li>
</ol>


<p>这只是 ReAct Loop。真正进入生产后，系统还要处理很多模型并不关心、但工程上无法回避的问题：</p>

<ul>
<li>任务跑到一半进程崩了，怎么恢复？</li>
<li>用户中途追加指令，应该插入哪一步？</li>
<li>多个工具能否并行，写操作如何避免竞争？</li>
<li>哪些命令可以直接运行，哪些必须审批？</li>
<li>上下文太长时，如何压缩但不破坏工具调用配对？</li>
<li>子 Agent 的状态、权限和工作区如何隔离？</li>
<li>同一个 Agent 如何同时服务多个用户和会话？</li>
<li>如何观察、审计和干预一个正在运行的任务？</li>
</ul>


<p>Harness 就是包围在模型循环之外的这一整层工程系统。</p>

<p>从这个定义看，两边虽然都叫 Harness，但边界不同。</p>

<p>DeepSeek Harness 的产品边界从底层事件、工具和文件系统能力，一直延伸到 Web UI、CLI、SDK 和插件开发体系。运行中的 <code>dsh</code> 本身就是一棵插件树。</p>

<p>AgentScope Java 则更明确地分成三层：</p>

<ul>
<li><code>agentscope-core</code> 提供模型、消息、工具、事件和 <code>ReActAgent</code></li>
<li><code>agentscope-harness</code> 在 Core 之上叠加工作区、记忆、压缩、技能、子 Agent、沙箱等能力</li>
<li><code>agentscope-service</code> 再向上提供 Agent 注册、Session 管理、团队编排、Dashboard 和分布式控制面</li>
</ul>


<p>所以，更准确的对比不是“框架 A 对框架 B”，而是：</p>

<blockquote><p><strong>一套高度可组合的 Agent 产品运行时，对比一套 Java Agent 框架及其生产服务平台。</strong></p></blockquote>

<h2>二、DeepSeek Harness：把整个 Agent Runtime 做成插件树</h2>

<p>DeepSeek Harness 最鲜明的设计不是工具多，也不是 UI 完整，而是它真的贯彻了“一切皆插件”。</p>

<p>底层的 <a href="https://github.com/cordiverse/cordis">Cordis</a> 提供共享 Context、服务注册、类型化事件和可撤销副作用。模型适配器、工具注册表、会话日志、Agent Loop，甚至持久化与沙箱策略，都是挂载在同一棵树上的插件。</p>

<p>这意味着系统里没有一个必须不断打补丁的“神圣内核”。一个插件注册服务、工具或监听器时，这些注册都会绑定到插件生命周期；插件卸载时，副作用也会被撤销。依赖服务消失，消费它的插件会一起卸载；服务恢复后，再重新加载。</p>

<p>这套设计带来三个很强的能力。</p>

<h3>1）运行时能力可以真正替换</h3>

<p>传统框架常见的“可插拔”，其实只是允许你传一个接口实现。DeepSeek Harness 的粒度更细：</p>

<ul>
<li>模型是 provider</li>
<li>文件系统是 provider</li>
<li>Shell、PTY、LSP 是 provider</li>
<li>Session Persistence 是 provider</li>
<li>Subagent 也是 provider</li>
<li>工具、提示词片段、审批和遥测都通过事件与服务组合</li>
</ul>


<p>例如把本地文件系统和进程执行替换成 E2B provider，Shell、文件工具等消费者可以继续复用同一套上层语义。它强调的是“能力接缝”（capability seam），而不是在每个工具内部判断当前跑在本机、容器还是远端。</p>

<p>这很适合构建 Coding Agent：底层执行世界会变化，但上层 Agent Loop 不应该跟着分叉。</p>

<h3>2）插件卸载和 HMR 是架构能力，不是开发便利</h3>

<p>因为注册本身就是可撤销副作用，DeepSeek Harness 可以在运行时卸载、替换、重新挂载插件。配置文件变化时，Loader 会比较配置项，只重载发生变化的部分；无效的新配置不会摧毁当前可用的插件树。</p>

<p>这不只是“保存文件后少重启一次”。它说明这个系统从一开始就在处理一个困难问题：<strong>动态变化的能力集合，如何不留下失效引用和脏状态。</strong></p>

<p>对于需要安装第三方插件、切换 Agent Profile、运行不同产品形态的系统，这个底座很有价值。</p>

<h3>3）扩展行为主要通过事件进入，而不是修改主循环</h3>

<p>DeepSeek Harness 把事件分成三个域：</p>

<ul>
<li>Session Event：需要持久化、重启后仍然存在的事实</li>
<li><code>agent/*</code> Event：正在运行的 Agent 状态与控制</li>
<li>Capability Event：文件系统、工具、遥测等能力自己的策略扩展点</li>
</ul>


<p>例如工具执行不是简单调用一个函数，而是经过：</p>

<p><code>pre-execute → 单调守卫 → execute → post-execute → finalize → result</code></p>

<p>审批、沙箱、超时、重试、指标、结果改写都可以挂在流水线上，不必让具体工具直接依赖这些策略。</p>

<p>这类设计的好处是扩展面非常清楚；代价则是概念多、学习曲线陡。你必须理解 Context、Service、Effect、Scope、Waterfall Event、Profile、Bundle 和 Patch，才能真正驾驭它。</p>

<h2>三、DeepSeek Harness 最值得看的设计：事件日志才是真相</h2>

<p>我认为 DeepSeek Harness 最有含金量的部分，不是插件，而是它对 Session 的定义。</p>

<p>它把会话建模为一份<strong>只追加的事件日志</strong>。<code>turn/start</code>、<code>step/start</code>、用户消息、模型流式 chunk、完整 assistant message、工具调用、工具结果和结束边界都会进入日志。</p>

<p>模型看到的上下文不是另一份独立状态，而是通过 <code>deriveMessages()</code> 从日志投影出来。</p>

<p>它甚至把原则写得非常直接：</p>

<blockquote><p>模型可见即已记录。</p></blockquote>

<p>这句话很重要。很多 Agent 系统同时维护三份相似但不完全一致的状态：</p>

<ul>
<li>发给模型的上下文</li>
<li>展示给用户的聊天记录</li>
<li>用于恢复任务的持久化快照</li>
</ul>


<p>一旦三者漂移，就会出现最难查的 Agent Bug：界面上看到了某条消息，但模型没看到；模型根据某段隐藏上下文做了决定，但重启恢复后这段上下文丢了。</p>

<p>DeepSeek Harness 试图从结构上消灭这种分叉。原始流式 chunk 保证 UI 可以精确回放；完整消息用于派生模型历史；压缩通过 surface replacement 表达；fork、resume、transcript 和 telemetry 都从同一事件流产生。</p>

<p>Crash Recovery 也遵循这个思路：如果载入时发现一个 <code>turn/start</code> 没有对应的 <code>turn/end</code>，系统不会粗暴截断已经持久化的长任务，而是补上一个 <code>interrupted</code> 结束事件，保留中断前已经发生的事实。</p>

<p>这种做法更像事件溯源系统，而不是传统聊天记录。</p>

<p>它的收益是：</p>

<ul>
<li>可重放</li>
<li>可审计</li>
<li>可恢复</li>
<li>可 fork</li>
<li>UI 与模型上下文更容易保持一致</li>
</ul>


<p>但它也把兼容性压力集中到了事件协议上。当前 Session 格式版本仍是 <code>0</code>，官方明确表示没有兼容承诺；一旦事件含义变化，迁移就会成为非常严肃的问题。</p>

<h2>四、工具执行：DeepSeek Harness 更像调度器，AgentScope 更像企业框架</h2>

<p>工具调用是比较两个项目时最能体现设计差异的地方。</p>

<h3>DeepSeek Harness：每次调用动态分类</h3>

<p>DeepSeek Harness 会为每一个待执行调用查询 <code>executionMode</code>：</p>

<ul>
<li><code>parallel</code> 可以与相邻安全调用重叠</li>
<li><code>exclusive</code> 必须独占执行，并形成顺序屏障</li>
</ul>


<p>Agent Loop 使用滚动并发池执行安全调用，同时保证结果仍按模型调用顺序写回。更关键的是，分类发生在调用级，而不只是工具级。理论上，同一个工具可以根据本次参数判断它是只读操作，还是需要独占的写操作。</p>

<p>它的工具流水线还把权限、单调守卫、沙箱、超时、重试、结果规范化和持久化观察分开。任何一层失败，都要被转成唯一、可记录的最终结果。</p>

<h3>AgentScope Java：默认并发，加安全标记</h3>

<p>AgentScope Java 2.0 的 Toolkit 默认开启并行执行。工具可以通过 <code>concurrencySafe</code> 标记自己是否能安全并发；连续的安全工具会并发运行，不安全工具形成串行槽位，输出顺序仍然保留。</p>

<p>这已经比“整个批次要么全并行、要么全串行”细很多，也很符合 Java 工程团队的使用习惯。但它当前主要还是工具定义级标记，表达力不如 DeepSeek Harness 的调用级动态分类。</p>

<p>因此，如果你在做文件编辑、终端、数据库变更这类副作用复杂的 Coding Agent，DeepSeek Harness 的执行语义更精细；如果大多数工具本身就是业务 API，AgentScope 的模型更直接，也更容易让普通团队理解。</p>

<h2>五、Code Mode：不是让 Agent 写业务代码，而是让它编排工具</h2>

<p>DeepSeek Harness 还有一个很有辨识度的能力：Code Mode。</p>

<p>普通 Function Calling 会把每个工具的完整 JSON Schema 暴露给模型，模型每调用一次工具，结果又会进入对话上下文。工具一多，Schema 和中间结果会持续占用 Token。</p>

<p>Code Mode 则只向模型暴露一个 <code>run_code</code> 入口和一份自动生成的 TypeScript 或 Python SDK。模型在临时程序中调用：</p>

<figure class='code'><div class="highlight"><table><tr><td class="gutter"><pre class="line-numbers"><span class='line-number'>1</span>
<span class='line-number'>2</span>
<span class='line-number'>3</span>
<span class='line-number'>4</span>
<span class='line-number'>5</span>
</pre></td><td class='code'><pre><code class=''><span class='line'>const files = await tools.glob({ pattern: "**/*.java" })
</span><span class='line'>const results = await Promise.all(
</span><span class='line'>  files.slice(0, 10).map(file =&gt; tools.read({ path: file }))
</span><span class='line'>)
</span><span class='line'>return results.map(item =&gt; extractWhatMatters(item))</span></code></pre></td></tr></table></div></figure>


<p>中间工具结果留在本次执行局部，只有 <code>return</code> 或 <code>console.log</code> 的内容回到模型上下文。</p>

<p>这带来的价值不是“模型会写代码”——Coding Agent 本来就会——而是：</p>

<ul>
<li>用程序表达循环、分支和聚合</li>
<li>独立只读调用可以显式并发</li>
<li>大量中间结果不必全部进入对话</li>
<li>工具返回值保留结构化类型，而不是来回解析文本</li>
</ul>


<p>它本质上是把一部分 Agent 编排从自然语言推理迁移到一次性的确定性程序中。</p>

<p>不过 Code Mode 也不是免费午餐。当前每次运行都是全新状态，不是持久 REPL；中间值不能从会话日志重建，而且执行局部没有统一字节上限。如果程序拿回超大对象，仍然可能造成 worker 内存压力。</p>

<h2>六、AgentScope Java：Core、Harness、Service 三层一起解决生产问题</h2>

<p>如果说 DeepSeek Harness 的关键词是“可组合”，AgentScope Java 的关键词就是“可运营”。</p>

<p>它的双层 Agent 结构很清楚。</p>

<p><code>ReActAgent</code> 负责核心推理循环，把模型、Toolkit、权限、Middleware、事件和 <code>AgentState</code> 组合起来；<code>HarnessAgent</code> 是外层包装，通过固定顺序的 Middleware 和工具，增加工作区、长期记忆、上下文压缩、技能、子 Agent、沙箱和 Plan Mode。</p>

<p>这种设计没有追求“一切皆插件”的纯粹性，而是刻意保留一个容易使用的 Builder：</p>

<figure class='code'><div class="highlight"><table><tr><td class="gutter"><pre class="line-numbers"><span class='line-number'>1</span>
<span class='line-number'>2</span>
<span class='line-number'>3</span>
<span class='line-number'>4</span>
<span class='line-number'>5</span>
</pre></td><td class='code'><pre><code class=''><span class='line'>HarnessAgent agent = HarnessAgent.builder()
</span><span class='line'>        .name("assistant")
</span><span class='line'>        .model("dashscope:qwen-plus")
</span><span class='line'>        .workspace(Paths.get(".agentscope/workspace"))
</span><span class='line'>        .build();</span></code></pre></td></tr></table></div></figure>


<p>对于 Java 团队，这种体验很熟悉：核心抽象稳定，基础设施通过 Builder 和 Spring Boot Starter 接入，扩展行为走 Middleware。</p>

<p>更重要的是，AgentScope Java 没有停在 SDK 层。仓库中的 <code>agentscope-service</code> 已经把 Agent 运行进一步拆成 Gateway、Control Plane、Dataplane 和 Scheduler，并提供 Dashboard、Managed Agents 与 Agent Teams。</p>

<p>因此它真正想解决的不是“如何写出一个聪明的 Agent”，而是：</p>

<blockquote><p><strong>一家公司里有很多 Agent、很多用户和很多运行副本时，怎样统一注册、恢复、观察、调度和治理。</strong></p></blockquote>

<h2>七、状态模型：一个强调重放，一个强调恢复与隔离</h2>

<p>两边都重视持久化，但设计中心不同。</p>

<h3>DeepSeek Harness：从事件重建会话</h3>

<p>DeepSeek Harness 以 append-only Session Event Log 为 Source of Truth。状态恢复、模型历史和 UI 展示尽量从事件投影得到。</p>

<p>这是偏运行时语义的选择：重点是“过去到底发生了什么”。</p>

<h3>AgentScope Java：从 RuntimeContext 找到 AgentState</h3>

<p>AgentScope Java 把状态分成几层：</p>

<ul>
<li><code>RuntimeContext</code>：当前调用的 <code>userId</code>、<code>sessionId</code> 和临时属性，不持久化</li>
<li><code>AgentState</code>：对话上下文、权限、Plan Mode 和工具状态，通过 <code>AgentStateStore</code> 跨调用恢复</li>
<li>Session JSONL：长期保留的对话流水账</li>
<li>Workspace Memory：每日只追加记忆和聚合后的 <code>MEMORY.md</code></li>
<li>Sandbox Snapshot：容器文件、安装依赖和运行环境的快照</li>
</ul>


<p>同一个 Agent 实例可以服务多个用户和会话。系统通过 <code>(userId, sessionId)</code> 定位状态；同一 Session 的调用串行化，不同 Session 可以并行。再配合 Redis、MySQL、PostgreSQL、OSS 或 COS 等后端，实例本身可以保持无状态并水平扩容。</p>

<p>这是偏服务架构的选择：重点是“下一次请求由任何副本接手时，怎样继续运行”。</p>

<p>两种模型没有绝对高下。</p>

<ul>
<li>要做可回放、可 fork、过程保真的 Agent 产品，事件溯源更有吸引力</li>
<li>要融入现有用户、租户、数据库和服务治理体系，状态存储模型更容易落地</li>
</ul>


<h2>八、沙箱：同样是隔离，关注点完全不同</h2>

<p>DeepSeek Harness 的本地 Sandbox 更贴近开发者桌面和 Coding Agent。Linux 可使用 bubblewrap / Landlock，macOS 使用 Seatbelt，Windows 有 ACL restricted-token runner。它强调同一宿主执行世界里的文件写入边界，并且在无法落实策略时 fail closed，而不是悄悄降级为无限制执行。</p>

<p>远端执行则不被塞进同一个进程沙箱接口，而是通过替换文件系统与进程 provider，把整个执行世界一起移动。目前仓库也已经提供 E2B 的文件系统和进程实现。</p>

<p>AgentScope Java 的沙箱更偏服务部署。它把 Docker、Kubernetes、Daytona、E2B 和 AgentRun 视为同类后端，并进一步考虑：</p>

<ul>
<li>按 User、Session、Agent 或 Global 隔离</li>
<li>容器消失后从快照恢复</li>
<li>快照放在本机、Redis、JDBC 或对象存储</li>
<li>多副本同时操作同一沙箱时使用分布式锁</li>
<li>对话状态和可执行环境一起跨请求续跑</li>
</ul>


<p>所以，DeepSeek Harness 更关心“这条命令在当前执行世界里是否越界”；AgentScope Java 更关心“这个租户的执行环境能否隔离、持久并被另一台机器接手”。</p>

<h2>九、多 Agent：一个先抽象 provider，一个先建设运营体系</h2>

<p>DeepSeek Harness 把 Subagent 做成可替换 capability seam。不同 provider 可以在同一 Context 共存：进程内 spawn、基于历史 fork，以及对接 Codex、Claude Code、ACP 或 DSH SDK 的外部执行器。</p>

<p>它还区分一次性子 Agent 和可继续对话的子 Agent。后者拥有持久 Session、可冷恢复的 Activation、唯一 inbox 和明确的父子授权关系。实验性的 Agent Teams 则在其上增加 roster、task board 和 mailbox。</p>

<p>AgentScope Java 的多 Agent 更贴近业务使用：</p>

<ul>
<li><code>agent_spawn</code> 创建同步或后台子任务</li>
<li><code>agent_send</code> 向已创建的子 Agent 继续发消息</li>
<li>超时的同步任务可以自动转为后台任务</li>
<li>后台结果通过消息总线反向通知父 Agent</li>
<li>Agent Teams 提供成员、任务认领、任务板和邮箱</li>
<li>Service 控制面负责跨实例注册、路由与观察</li>
</ul>


<p>简单说，DeepSeek Harness 优先解决的是“如何把不同 Subagent 实现放到同一个抽象后面”；AgentScope Java 优先解决的是“如何让一组 Agent 在企业平台里持续协作”。</p>

<h2>十、一张表看懂核心差异</h2>

<table>
<thead>
<tr>
<th> 维度 </th>
<th> DeepSeek Harness </th>
<th> AgentScope Java </th>
</tr>
</thead>
<tbody>
<tr>
<td> 核心定位 </td>
<td> 可组合 Agent Runtime 与产品底座 </td>
<td> Java Agent 框架、Harness 与服务平台 </td>
</tr>
<tr>
<td> 技术栈 </td>
<td> TypeScript / Node.js，含 Web、Native 与 Python SDK </td>
<td> Java 17 / Reactor / Maven / Spring Boot，Service 含 Go 与前端 </td>
</tr>
<tr>
<td> 核心抽象 </td>
<td> Cordis Context、Plugin、Service、Event、Effect、Scope </td>
<td> Agent、ReActAgent、HarnessAgent、Middleware、RuntimeContext、AgentState </td>
</tr>
<tr>
<td> 执行循环 </td>
<td> Turn / Step 边界明确，行为大量通过事件拦截 </td>
<td> ReAct 核心循环稳定，Harness 通过 Middleware 叠加能力 </td>
</tr>
<tr>
<td> 状态真相 </td>
<td> Append-only Session Event Log </td>
<td> AgentStateStore + Session Log + Workspace / Memory </td>
</tr>
<tr>
<td> 回放能力 </td>
<td> 强，原始 chunk、调用与结果都进入事件日志 </td>
<td> 更偏事件流展示和状态恢复，不以统一事件溯源为核心 </td>
</tr>
<tr>
<td> 工具并发 </td>
<td> 调用级 <code>parallel</code> / <code>exclusive</code> 分类与屏障 </td>
<td> Toolkit 批量并发，工具级 <code>concurrencySafe</code> 标记 </td>
</tr>
<tr>
<td> 工具扩展 </td>
<td> 多阶段 waterfall、守卫、审批、沙箱、结果规范化 </td>
<td> Toolkit、权限系统、Middleware、执行配置 </td>
</tr>
<tr>
<td> Code Mode </td>
<td> 原生支持 TypeScript / Python 工具编排 </td>
<td> 不是当前核心设计 </td>
</tr>
<tr>
<td> 沙箱 </td>
<td> 本机强制隔离 + E2B provider，可替换整个执行世界 </td>
<td> Docker / K8s / Daytona / E2B / AgentRun，快照与分布式锁完整 </td>
</tr>
<tr>
<td> 多 Agent </td>
<td> 多 provider、一次性与可继续子 Agent、实验性 Teams </td>
<td> 同步/后台子 Agent、持久任务、Teams 与控制面 </td>
</tr>
<tr>
<td> 企业集成 </td>
<td> 需要自行组合和建设 </td>
<td> Redis、MySQL、PostgreSQL、OSS、COS、Nacos、Spring Boot、Channel </td>
</tr>
<tr>
<td> 产品形态 </td>
<td> CLI、Web、Headless、SDK、插件 Profile </td>
<td> Core、Harness、Extensions、Service、Dashboard </td>
</tr>
<tr>
<td> 当前成熟度 </td>
<td> <code>0.1.0-rc.8</code>，Developer Preview </td>
<td> 2.0 已 GA，主干继续快速迭代 </td>
</tr>
</tbody>
</table>


<h2>十一、两边各自最需要警惕什么</h2>

<h3>DeepSeek Harness：架构漂亮，不等于现在就适合所有生产系统</h3>

<p>它的风险主要有三个。</p>

<p>第一，项目仍处于 Developer Preview，当前版本是 <code>0.1.0-rc.8</code>，官方明确提示后续会有破坏性变化。Session 格式也是预发布的 v0，没有内置迁移链。</p>

<p>第二，Cordis 的抽象能力很强，但认知成本也高。插件树、Service 注入、Scope 隔离、Effect 回收、Waterfall Event、Bundle 和 Patch 共同工作时，调试难度不低。</p>

<p>第三，它更像一个完整产品底座，而不是一个轻量 SDK。如果团队只是想在已有业务里增加几个 Agent 能力，引入整套运行时未必划算。</p>

<h3>AgentScope Java：生产面完整，但核心类正在承受复杂度</h3>

<p>AgentScope Java 的风险也很明显。</p>

<p>首先，<code>ReActAgent</code> 和 <code>HarnessAgent</code> 都已经是体量很大的中心类。大量能力虽然通过 Middleware、Toolkit 和 Builder 暴露，但编排与兼容逻辑仍集中在核心实现里。未来功能继续增加时，维护成本值得关注。</p>

<p>其次，它的“可扩展”更接近企业框架的扩展方式，而不是 DeepSeek Harness 那种运行时级可替换。你可以加 Middleware、工具和 Store，但很难像 Cordis 一样把整个 Agent Loop 当成普通插件换掉。</p>

<p>最后，AgentScope Service 已经覆盖控制面、托管运行时和 Teams，能力很诱人，但这也意味着更重的部署和运维成本。只有当组织真的存在多 Agent、多租户、多副本和统一治理需求时，这一层平台才有足够回报。</p>

<h2>十二、到底怎么选</h2>

<p>如果你的目标是下面这些，优先研究 DeepSeek Harness：</p>

<ul>
<li>做自己的 Coding Agent、IDE Agent 或桌面 Agent</li>
<li>希望替换模型、文件系统、Shell、Subagent 和持久化实现</li>
<li>强调会话回放、fork、恢复和过程保真</li>
<li>需要插件市场、动态装卸或多种产品 Profile</li>
<li>想研究 Code Mode 和更精细的工具执行语义</li>
</ul>


<p>如果你的目标是下面这些，优先考虑 AgentScope Java：</p>

<ul>
<li>企业核心系统本来就在 Java / Spring Boot 生态</li>
<li>一个 Agent 需要服务大量用户和 Session</li>
<li>需要 Redis、数据库、对象存储与跨副本恢复</li>
<li>需要长期记忆、技能治理、Channel 和多租户隔离</li>
<li>希望进一步建设 Agent Dashboard、Managed Agents 或统一控制面</li>
</ul>


<p>还有一种常见情况：团队只是验证一个小型 Agent 功能。</p>

<p>这种时候，两套方案都可能太重。直接使用简单的模型 SDK、少量工具和一个清楚的状态边界，往往更合适。<strong>不要因为 Harness 很先进，就默认所有 Agent 都需要 Harness。</strong></p>

<h2>十三、最后的判断：它们代表了 Agent 工程化的两种未来</h2>

<p>DeepSeek Harness 展示的是一种 Runtime-first 路线：</p>

<blockquote><p>把 Agent 的每一项能力都变成可组合、可替换、可回收的运行时部件，再用统一事件日志保证执行语义。</p></blockquote>

<p>AgentScope Java 展示的是一种 Production-first 路线：</p>

<blockquote><p>把 Agent 纳入成熟的应用服务体系，解决租户、状态、沙箱、存储、渠道、调度和控制面，再让企业真正运营它。</p></blockquote>

<p>前者更像在设计 Agent 时代的“运行时内核”，后者更像在建设 Agent 时代的“应用服务器与控制平台”。</p>

<p>两边最终很可能会互相靠近：DeepSeek Harness 会继续补生产基础设施，AgentScope Java 也会继续细化运行时语义。但至少在当前阶段，选型边界非常清楚：</p>

<blockquote><p><strong>造 Agent Runtime 和产品，选 DeepSeek Harness；在企业系统里运行和治理 Agent，选 AgentScope Java。</strong></p></blockquote>

<p>这也说明 Agent 开发已经进入了一个新阶段。竞争不再只是“谁的模型更聪明”或“谁的 Demo 工具更多”，而是：</p>

<p><strong>谁能把不确定的模型行为，装进一套可恢复、可解释、可扩展、可治理的软件系统。</strong></p>

<hr />

<p>本文阅读基线为 2026 年 8 月 21 日，主要参考两个仓库当时的主干源码与文档：DeepSeek Harness <code>141eb6f</code>（<code>0.1.0-rc.8</code>）和 AgentScope Java <code>643905e</code>。关键资料包括 <a href="https://github.com/deepseek-ai/deepseek-harness/blob/141eb6fef83422698aef7a981029e843e8161534/docs/architecture.zh.md">DeepSeek Harness 架构</a>、<a href="https://github.com/deepseek-ai/deepseek-harness/blob/141eb6fef83422698aef7a981029e843e8161534/docs/agent-lifecycle.zh.md">Agent 生命周期</a>、<a href="https://github.com/deepseek-ai/deepseek-harness/blob/141eb6fef83422698aef7a981029e843e8161534/docs/tool-execution-pipeline.zh.md">工具执行流水线</a>、<a href="https://github.com/agentscope-ai/agentscope-java/blob/643905e6bfdaabae50264048f69d58a43628c64c/docs/v2/zh/docs/harness/architecture.md">AgentScope Harness 架构</a>、<a href="https://github.com/agentscope-ai/agentscope-java/blob/643905e6bfdaabae50264048f69d58a43628c64c/docs/v2/zh/docs/building-blocks/agent.md">AgentScope Agent</a> 与 <a href="https://github.com/agentscope-ai/agentscope-java/blob/643905e6bfdaabae50264048f69d58a43628c64c/agentscope-service/README_zh.md">AgentScope Service</a>。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[从 Agent Readable 到 IM 群协作：我对企业 AI Native 改造的终局思考]]></title>
    <link href="https://www.rowkey.cn/blog/2026/08/06/enterprise-ai-native-architecture-and-im-workspace/"/>
    <updated>2026-08-06T11:28:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/08/06/enterprise-ai-native-architecture-and-im-workspace</id>
    <content type="html"><![CDATA[<p>最近一直在深度思考和实践“企业如何实现 AI Native”。</p>

<p>在看了大量架构方案、也踩了不少落地坑之后，我越来越确信一件事：<strong>AI Native 绝不是买几个大模型账号，也不是强行造一个新系统给员工用。</strong></p>

<p>如果脱离了企业的真实数据生态和员工的习惯路径，所谓的 AI Native 改造只是一场昂贵的“技术自嗨”。</p>

<p>今天把最近关于 AI Native 落地的前提、短中期痛点、协同载体以及终局形态的思考梳理出来，供大家参考。</p>

<!-- more -->


<h2>一、企业级 AI Native 落地全景架构</h2>

<p>在探讨具体协同载体之前，我们先拉高视角，看一张企业级 AI Native 落地全景架构图。</p>

<p>整个架构从上到下分为应用场景层、能力解耦层、核心 Runtime 运行时以及底座资源支撑层：</p>

<p><img src="https://www.rowkey.cn/images/2026-08-06-enterprise-ai-native-architecture.png" alt="" /></p>

<p>这张架构图体现了两个核心逻辑：
1. <strong>能力解耦与治理（Skill/MCP Hub）</strong>：将数据、工具和系统能力标准化暴露，解决安全鉴权与复用问题。
2. <strong>场景双轮驱动</strong>：既包含了研发侧的 Vibe Coding，也涵盖了全公司业务与职能形态的 Agent 化。</p>

<p>后文讨论的所有“Agent Readable”、“IM 协同”以及“私有 Runtime”，本质上都是这张架构图在具体工程和组织管理中的落地延伸。</p>

<hr />

<h2>二、AI Native 的首要前提：解决 Agent Readable</h2>

<p>绝大多数企业在喊 AI Native 时，第一步就卡住了。</p>

<p>原因很简单：大模型虽然聪明，但它对企业内部的真实情况一无所知。</p>

<p>企业要真正走向 AI Native，第一个关键基础设施不是选哪个模型，而是实现 <strong>Agent Readable（Agent 可读化）</strong>：</p>

<ul>
<li><strong>数据可读</strong>：数据库、数据仓库、日志、指标是否暴露成了 Agent 可领会的结构？</li>
<li><strong>文档与知识可读</strong>：PRD、合同、FAQ、研发文档是否离散在各种乱七八糟的本地文件夹里？</li>
<li><strong>系统与资源可读</strong>：企业的各种业务后台、HR 系统、财务系统、CI/CD 管道，是否有标准的 MCP Server 或 API 供 Agent 发现与调用？</li>
</ul>


<p><strong>只有企业的核心数据、知识与资源变成了 Agent 可以安全获取、读取和理解的形式，AI Native 的改造才有底座。</strong></p>

<hr />

<h2>三、冷静看效益：短期是成本，长期才是提效</h2>

<p>很多人对 AI Native 抱有不切实际的幻想，认为一旦引入立刻就能全员提效。</p>

<p>现实往往相反：<strong>短期内，AI Native 改造大概率是降效的。</strong></p>

<p>引入新技术必然带来额外的成本：</p>

<ul>
<li><strong>学习成本</strong>：员工需要学习如何与 Agent 交互、如何撰写规范的 Prompt 和设计约束。</li>
<li><strong>改造成本</strong>：系统 API 的 MCP 化改造、数据治理、安全与风控护栏的搭建。</li>
<li><strong>磨合成本</strong>：人机协同流程中的摩擦与失控风险。</li>
</ul>


<p>管理者必须有清醒的认知：<strong>短期内我们在为“认知升级和工程基础设施”买单，长期来看，当 Agent 能够自主吞吐数据与执行流程时，指数级的提效才会真正爆发。</strong></p>

<hr />

<h2>四、为什么办公 IM 是 AI Native 的最佳协作载体？</h2>

<p>最近观察到飞书、钉钉、企微等办公软件频繁调整组织架构和 AI 战略，这与我们探索的“企业 Workspace”方向完全吻合。</p>

<p>未来企业真的需要为了 AI 专门再开发一套全新的协作平台吗？答案大概率是：<strong>不需要，甚至应该坚决避免。</strong></p>

<p>重新造一个新平台，面临最大的阻力就是<strong>用户习惯路径的迁移</strong>。而钉钉/飞书/企微有着得天独厚的优势：</p>

<ol>
<li><strong>资源天然沉淀</strong>：企业的组织架构、文档、审批、知识库早已沉淀在上面，天然具备实现 Agent Readable 的基础。</li>
<li><strong>零迁移阻力</strong>：员工早已习惯了每天在上面沟通和协同，不需要改变任何工作习惯。</li>
<li><strong>天然的 Agent 学习场（群聊即 SOP）</strong>：

<ul>
<li>协作最好的形式可能就是<strong>群聊</strong>（正如海外企业在 Slack 中实现的那样）。</li>
<li>传统企业写 SOP 是极其昂贵且容易过期的，但群聊历史天然是“带有上下文、有纠错过程、有结果验证”的真实表达。Agent 驻留在群里，只需观察群里的历史沟通，就能通过无感的 In-Context Learning 隐性学习到团队的业务 SOP 和规则，自然而然掌握这项技能。</li>
</ul>
</li>
</ol>


<hr />

<h2>五、终局思考：私有大脑 + 标准 IM 接口</h2>

<p>虽然用户界面不需要自研，但这并不意味着企业不需要自己的基础设施。</p>

<p>从数据安全性、模型路由与 Runtime 多样性的角度来看，企业<strong>必须拥有私有的 Agent 运行与治理能力</strong>。</p>

<p>因此，理想的终局形态是明确的解耦：<strong>UI 交互层归办公 IM，运行治理层（私有大脑）归企业自建。</strong></p>

<ul>
<li><strong>交互层（办公 IM）</strong>：提供人类最熟悉的 UI 和消息通道，零成本承载人机协同。</li>
<li><strong>治理层（私有 Runtime）</strong>：承载真正的核心逻辑、私有模型路由（TokenHub）、代码沙箱隔离（Sandbox）以及自定义 MCP 工具链。</li>
</ul>


<p>试想这样一个未来的产研闭环场景：</p>

<ol>
<li><strong>需求提出</strong>：你在钉钉/飞书的项目协作群里，直接 <code>@产品经理 Agent</code>：“我们需要增加一个根据用户行为自动生成周报的功能。”</li>
<li><strong>需求细化</strong>：产品经理 Agent 接到需求，在群里进行需求拆解与澄清，生成结构化 PRD，随后自动 <code>@研发 Agent</code>。</li>
<li><strong>代码与部署</strong>：研发 Agent 分析需求、设计架构、编写代码，并通过 CI/CD 自动部署到测试环境，最后 <code>@产品经理 Agent</code> 验收。</li>
<li><strong>验收上线</strong>：产品经理 Agent 完成验收，自动触发发布流程，并在群里汇报“已上线”。</li>
</ol>


<p>在这个过程中：</p>

<ul>
<li><strong>全流程透明</strong>：人类管理者和团队成员可以在群里看到所有的执行节点与进度。</li>
<li><strong>随时介入</strong>：一旦 Agent 在任何一步偏离预期或遇到风险，人类可以随时 <code>@</code> 介入打断或修正。</li>
<li><strong>闭环打通</strong>：完全打通了从需求到上线的产研全流程。</li>
</ul>


<hr />

<h2>六、总结</h2>

<p>总结来看，企业 AI Native 改造的底层主线已经非常清晰：</p>

<ol>
<li><strong>以 Agent Readable 为基石</strong>：搞好数据治理与能力暴露。</li>
<li><strong>以成熟 IM 为协同界面</strong>：借力钉钉/飞书/企微，降低用户迁移门槛，用群聊作为 Agent 学习与交互的场。</li>
<li><strong>以私有 Runtime 为安全大脑</strong>：保证数据安全、管控模型成本（TokenHub），并实现多 Agent 的群流转。</li>
</ol>


<p>打破幻想，扎实建设基础设施，才能真正拥抱 AI Native 的时代。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[AI大事记@2026H1]]></title>
    <link href="https://www.rowkey.cn/blog/2026/07/05/ai-2026-h1/"/>
    <updated>2026-07-05T10:00:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/07/05/ai-2026-h1</id>
    <content type="html"><![CDATA[<p>2026 年上半年，AI 的演进明显从“单点能力竞赛”转向“完整工作能力竞赛”：模型开始统一推理、编程、多模态和工具调用，Agent 从演示走进真实工作流，图像与视频生成也在加速进入生产链路。</p>

<p>概括总结一下 2026 年上半年的关键 AI 事件。</p>

<!-- more -->


<table>
<thead>
<tr>
<th style="text-align:left;"> 时间 </th>
<th style="text-align:left;"> 事项 </th>
<th style="text-align:left;"> 备注 </th>
</tr>
</thead>
<tbody>
<tr>
<td style="text-align:left;"> <strong>2026.06.30</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Sonnet 5</strong> </td>
<td style="text-align:left;"> 面向日常 Agent 的主力模型升级，增强规划、浏览器与终端工具调用、编程和知识工作能力。官方定位接近 Opus 4.8，但价格更低，并成为 Free、Pro 用户的默认模型。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.06.30</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Science（Beta）</strong> </td>
<td style="text-align:left;"> 推出面向科研场景的 AI 工作台，整合文献、代码、科学工具和计算资源，图表与结果可追溯到生成代码及运行环境。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.06.09</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Fable 5 / Mythos 5</strong> </td>
<td style="text-align:left;"> 新增 Mythos 级模型：Fable 面向一般使用并强化安全防护，Mythos 面向可信网络防御计划。软件工程、知识工作、视觉理解与科研能力继续增强。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.05.28</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Opus 4.8</strong><br><strong>Claude Code Dynamic Workflows</strong> </td>
<td style="text-align:left;"> Opus 继续提升编程、工具调用与协作可靠性；Claude Code 同时推出 Dynamic Workflows 研究预览，可组织大量并行子 Agent 处理复杂任务。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.05.19</strong> </td>
<td style="text-align:left;"> <strong>Google Gemini 3.5 Flash</strong><br><strong>Gemini Spark</strong> </td>
<td style="text-align:left;"> Google I/O 发布新一代 Agent 主力模型，强化长程编程、工具协作和多模态理解。Gemini Spark 则展示了全天候个人 Agent 的产品方向。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.04.28</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude for Creative Work</strong> </td>
<td style="text-align:left;"> 新增 Adobe、Blender、Autodesk Fusion、SketchUp、Ableton 等创意工具连接器，让 Claude 直接参与设计、3D、音视频与批量制作流程。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.04.24</strong> </td>
<td style="text-align:left;"> <strong>DeepSeek V4 预览版</strong> </td>
<td style="text-align:left;"> 发布 V4-Pro 与 V4-Flash 两条产品线，主打 1M 上下文、开源与低成本，继续冲击闭源模型的价格体系。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.04.23</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT-5.5</strong> </td>
<td style="text-align:left;"> 主打真实工作场景，覆盖代码、联网研究、数据分析、文档与表格制作，以及跨软件执行；次日补充开放 API。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.04.21</strong> </td>
<td style="text-align:left;"> <strong>OpenAI ChatGPT Images 2.0</strong><br><strong>GPT-Image-Gen-2</strong> </td>
<td style="text-align:left;"> 新一代图像生成模型重点增强多语言文字渲染、版式、漫画、海报、信息图、真实感与复杂视觉表达。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.04.16</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Opus 4.7</strong> </td>
<td style="text-align:left;"> 强化复杂代码、长任务、视觉理解，以及文档、幻灯片和界面生成能力，同时引入更严格的网络安全使用限制。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.03.05</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT-5.4</strong> </td>
<td style="text-align:left;"> 将 GPT-5.3-Codex 的编程与电脑操作能力并入主线模型，支持 1M 上下文，明显增强办公文档、表格、演示、工具调用与 Computer Use。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.03.03</strong> </td>
<td style="text-align:left;"> <strong>Google Gemini 3.1 Flash-Lite</strong> </td>
<td style="text-align:left;"> 面向大规模调用的低成本模型，重点优化高吞吐、低价格和实用智能。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.02.26</strong> </td>
<td style="text-align:left;"> <strong>Google Nano Banana 2</strong><br><em>(aka Gemini 3.1 Flash Image)</em> </td>
<td style="text-align:left;"> 将 Nano Banana Pro 的图像质量、世界知识和编辑能力下放到 Flash 速度，定位为高质量图片生成与编辑的快速版本。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.02.19</strong> </td>
<td style="text-align:left;"> <strong>Google Gemini 3.1 Pro</strong> </td>
<td style="text-align:left;"> Gemini 3 系列主力模型升级，继续增强复杂推理、Agent 工作流、可视化与前端生成能力。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.02.17</strong> </td>
<td style="text-align:left;"> <strong>Anthropic Claude Sonnet 4.6</strong> </td>
<td style="text-align:left;"> Sonnet 系列大升级，提供 1M 上下文 Beta，增强代码、电脑操作、长上下文推理、Agent 规划和知识工作能力。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.02.12</strong> </td>
<td style="text-align:left;"> <strong>字节 Seedance 2.0</strong> </td>
<td style="text-align:left;"> 新一代视频创作模型，统一音视频生成，支持文本、图片、音频和视频等多模态输入。视频模型的竞争进一步进入“音画一体”阶段。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2026.02.05</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT-5.3-Codex</strong> </td>
<td style="text-align:left;"> Codex 从“辅助写代码”继续走向“电脑上的通用工作 Agent”，增强长任务、终端、调试、部署和研究工具链能力。 </td>
</tr>
</tbody>
</table>


<h2>半年观察</h2>

<h3>1. 编程模型与通用模型正在合流</h3>

<p>GPT-5.3-Codex 到 GPT-5.4 的演进很有代表性：编程、终端操作、工具调用和 Computer Use 不再只是专用模型的附加能力，而是逐渐并入通用主线模型。模型的衡量标准，也从回答一道题转向能否在真实环境中持续完成一项工作。</p>

<h3>2. Agent 的竞争焦点转向工作流</h3>

<p>Claude Code Dynamic Workflows、Gemini Spark，以及各家模型不断增强的浏览器和终端能力，共同说明 Agent 已经进入工程化阶段。上下文长度和单次推理成绩仍然重要，但任务拆解、工具协作、长时间运行、结果校验和失败恢复，正在成为决定实际体验的关键。</p>

<h3>3. 多模态开始接管专业生产链路</h3>

<p>Nano Banana 2、GPT-Image-Gen-2 和 Seedance 2.0 分别推动图片编辑、视觉表达与音视频联合生成。与此同时，Claude 通过连接 Adobe、Blender、Fusion 和 Ableton 等工具进入专业创作环境。多模态模型不再只负责“生成一个作品”，而是开始参与素材理解、编辑和交付的完整流程。</p>

<h3>4. 模型分层更加清晰</h3>

<p>2026 年上半年，各家都在同时经营旗舰模型、高性价比模型和受控专业模型。Pro、Sonnet、Flash、Lite、Fable、Mythos 等不同定位背后，是同一个趋势：企业不再只选“最强模型”，而是根据任务难度、延迟、成本和安全边界动态选择模型。</p>

<h2>小结</h2>

<p>如果说 2025 年的关键词是推理模型、多模态和 Agent 的集中爆发，那么 2026 年上半年更像是这些能力的汇合：模型正在成为一个能读懂环境、调用工具、组织任务并交付结果的工作系统。</p>

<p>下半年的竞争重点，也会从“谁又刷新了榜单”，进一步转向“谁能用更低成本、更稳定地完成真实任务”。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[从管人到管系统行为：AI时代技术管理者的全新认知框架]]></title>
    <link href="https://www.rowkey.cn/blog/2026/05/17/tech-leader-ai-era-cognitive-framework/"/>
    <updated>2026-05-17T11:44:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/05/17/tech-leader-ai-era-cognitive-framework</id>
    <content type="html"><![CDATA[<p>最近大量使用 AI 进行开发，我逐渐意识到一个趋势：随着 AI 编程的普及，被颠覆的不仅仅是一线工程师的工作方式，对 CTO、技术总监、技术 Leader 这些技术管理者的要求，正在发生截然不同的改变。</p>

<p>过去，技术管理的核心在于“人”与“确定性”；而现在，当 AI 开始接管代码生成，系统正在变得“非确定性”。如何理解和控制这种非确定性，将成为下一代技术管理者的核心壁垒。</p>

<!-- more -->


<h2>传统的确定性时代：管组织与做平衡</h2>

<p>在传统的软件工程时代，代码由工程师一行行敲出来，系统严格按照设定的逻辑执行。</p>

<p>这种模式下，系统是高度确定性的：输入相同，输出必然相同。如果出了 Bug，顺着调用栈一层层 Debug，总能找到引发异常的那行代码。因此，技术管理者不需要每天盯着系统的细枝末节，核心精力主要放在以下三件事：</p>

<ul>
<li><strong>管理复杂组织</strong>：搭建梯队、拆分团队、把控研发效能。</li>
<li><strong>决策技术路线</strong>：选型、架构演进、技术债务管理。</li>
<li><strong>平衡业务与工程</strong>：在有限的资源下，平衡需求交付进度与系统长期健康度。</li>
</ul>


<h2>AI 编程时代：非确定性带来的失控感</h2>

<p>当研发流程全面接入 AI，情况变了。</p>

<p>现在是工程师设计约束，AI 负责生成代码。这种模式打破了传统的确定性——同样的输入，AI 每次给出的实现细节可能完全不同。这带来了一系列连锁反应：</p>

<ul>
<li><strong>调试极其复杂</strong>：代码不再是人类思维的直接映射，遇到 Bug 时，由于存在机器生成的不可解释性，排查链路变长。</li>
<li><strong>系统难以理解</strong>：大量 AI 生成的代码交织在一起，如果不加以严格规范，系统会变成一个连创造者都看不透的黑盒。</li>
<li><strong>风险更难控制</strong>：非确定性的代码直接进入工程环节，边界变得模糊，安全和可用性风险急剧上升。</li>
</ul>


<h2>技术管理者的新定位</h2>

<p>在这样的背景下，技术管理者的核心工作，正在从单纯的“管人”向“管系统行为”演进。未来的首要任务，是解决<strong>“如何完全理解系统为什么这么运行”</strong>的问题。</p>

<p>技术管理者的新角色正在转变为：</p>

<ul>
<li><strong>系统约束设计者</strong>：从设计架构，转变为设计“AI 生成与运行的约束条件”。通过制定严格的上下文准入边界、静态检查校验规则以及自动化测试拦截网，让 AI 在可控轨道内工作。</li>
<li><strong>AI 能力整合者</strong>：准确判断系统的哪些模块该用传统逻辑保底，哪些模块可以放权给 AI 生成。将大模型能力无缝、安全地整合进既有的工程开发链路中。</li>
<li><strong>风险控制负责人</strong>：面对非确定性输出，必须建立一套全新的兜底与熔断机制。从架构设计上控制 AI 产生错误代码或不可控行为的爆炸半径。</li>
</ul>


<h2>结语：建立全新的认知框架</h2>

<p>本质上，AI 时代的研发管理，需要建立一套全新的认知框架。</p>

<p>从管理“人类开发者的产能”，升级为管理“人机协同系统的行为边界”。对现有的技术管理者来说，这不仅是脱离舒适区的巨大挑战，更是抓住下一次技术代差、重塑团队战斗力的绝佳机会。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[SOUL.md 和 AGENTS.md 到底有什么区别？Agent 配置别再混着写了]]></title>
    <link href="https://www.rowkey.cn/blog/2026/04/06/soul-vs-agents/"/>
    <updated>2026-04-06T00:17:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/04/06/soul-vs-agents</id>
    <content type="html"><![CDATA[<p>很多人开始配置自己的 Agent 时，都会很快遇到一个问题：</p>

<p><strong><code>SOUL.md</code> 和 <code>AGENTS.md</code> 看起来都像是在“定义 Agent”，它们到底有什么区别？</strong></p>

<p>如果这两个文件不分清，后面就很容易出现一种典型混乱：人格写进岗位说明，业务流程写进行为准则，文件越写越多，Agent 反而越来越不像一个稳定的助手。</p>

<p>先说结论：</p>

<ul>
<li><code>SOUL.md</code> 负责定义 <strong>这个 Agent 怎么做人、怎么做事、什么不能碰</strong></li>
<li><code>AGENTS.md</code> 负责定义 <strong>这个 Agent 是干什么的、服务谁、交付什么、按什么流程工作</strong></li>
</ul>


<p>一句话：</p>

<p><strong><code>SOUL.md</code> 是灵魂，<code>AGENTS.md</code> 是岗位说明书。</strong></p>

<!-- more -->


<h2>一、为什么很多人会把这两个文件写混</h2>

<p>原因其实很简单：这两个文件都在描述 Agent，而且都不是技术配置项，而是自然语言规则。</p>

<p>于是很容易出现下面这种误写：</p>

<ul>
<li>在 <code>SOUL.md</code> 里写“每周发 3 篇小红书”</li>
<li>在 <code>AGENTS.md</code> 里写“说话别太啰嗦，先给结论”</li>
</ul>


<p>表面上看都能运行，但问题在于：</p>

<ul>
<li>文件边界开始模糊</li>
<li>后续维护的人不知道该改哪</li>
<li>Agent 接收到的行为信号会互相打架</li>
</ul>


<p>这就像你在公司里把“企业文化”和“岗位 KPI”写进同一张纸。</p>

<p>短期看没事，长期一定乱。</p>

<h2>二、<code>SOUL.md</code> 适合放什么</h2>

<p><code>SOUL.md</code> 更适合放那些<strong>跨任务长期有效的行为原则</strong>。</p>

<p>也就是：不管这个 Agent 今天在写文章、查资料、做排期，还是和你对话，它都应该稳定遵守的那一层规则。</p>

<p>它更像下面这些问题的答案：</p>

<ul>
<li>我应该怎么说话？</li>
<li>我做判断时遵循什么原则？</li>
<li>遇到边界问题时，什么必须先请示？</li>
<li>我的默认工作风格是什么？</li>
</ul>


<p>它适合放的内容，大致可以分成 4 类：</p>

<h3>1）表达风格</h3>

<p>比如：</p>

<ul>
<li>少客套，直接给价值</li>
<li>先结论，后细节</li>
<li>默认中文简体</li>
<li>可以适度直接，但不要油腻</li>
</ul>


<h3>2）行为原则</h3>

<p>比如：</p>

<ul>
<li>先做功课再提问</li>
<li>先保护用户，再追求效率</li>
<li>不编造来源</li>
<li>不确定信息必须标注待核实</li>
</ul>


<h3>3）边界与禁区</h3>

<p>比如：</p>

<ul>
<li>未经确认，不对外发布</li>
<li>不擅自联系他人</li>
<li>不替用户做超出授权的决定</li>
<li>涉及隐私和敏感内容默认谨慎</li>
</ul>


<h3>4）协作偏好</h3>

<p>比如：</p>

<ul>
<li>输出长度偏中等</li>
<li>不要太啰嗦</li>
<li>允许直接指出低效做法</li>
<li>遇到复杂问题先自己查，不要先把问题甩回给用户</li>
</ul>


<p>这些东西有一个共同点：</p>

<p><strong>它们不依赖具体业务，而定义的是这个 Agent 的稳定人格和做事方式。</strong></p>

<h2>三、<code>AGENTS.md</code> 适合放什么</h2>

<p>如果说 <code>SOUL.md</code> 解决的是“怎么做人”，那么 <code>AGENTS.md</code> 解决的就是“你到底是干什么的”。</p>

<p>它更适合放那些<strong>业务身份、职责范围、目标、流程和输出物</strong>。</p>

<p>它更像下面这些问题的答案：</p>

<ul>
<li>这个 Agent 的岗位是什么？</li>
<li>它服务谁？</li>
<li>它追求什么业务目标？</li>
<li>它平时交付哪些内容？</li>
<li>它按照什么 workflow 工作？</li>
</ul>


<p>通常来说，<code>AGENTS.md</code> 更适合放 5 类内容。</p>

<h3>1）角色定位</h3>

<p>比如：</p>

<ul>
<li>你是内容运营助理</li>
<li>你是产品助理</li>
<li>你是客服助理</li>
<li>你是销售支持助理</li>
</ul>


<h3>2）业务目标</h3>

<p>比如：</p>

<ul>
<li>沉淀知识资产</li>
<li>建立个人品牌</li>
<li>提升团队交付效率</li>
<li>降低重复沟通成本</li>
</ul>


<h3>3）服务对象 / 平台 / 受众</h3>

<p>比如：</p>

<ul>
<li>主要平台：公众号、小红书</li>
<li>目标受众：AI 从业者、程序员、Java 工程师</li>
<li>服务对象：HJ 本人和他的内容业务</li>
</ul>


<h3>4）核心工作流</h3>

<p>比如：</p>

<ul>
<li>收集输入</li>
<li>梳理观点</li>
<li>生成提纲</li>
<li>产出长文 / 短帖 / 配图提示词</li>
<li>发布前检查</li>
<li>复盘内容表现</li>
</ul>


<h3>5）默认交付物和衡量标准</h3>

<p>比如：</p>

<ul>
<li>默认产出长文、小红书文案、短帖摘要、封面文案</li>
<li>复盘优先级：阅读 > 收藏 > 转发</li>
<li>每周更新频率和平台节奏</li>
</ul>


<p>这些内容有一个共同点：</p>

<p><strong>它们定义的是这个 Agent 的工作岗位，而不是性格。</strong></p>

<h2>四、最直白的判断方法：一句规则到底回答了什么问题</h2>

<p>如果你拿到一条规则，不知道该放哪，就问自己一句：</p>

<p><strong>它到底在回答“我怎么做事”，还是“我做什么事”？</strong></p>

<h3>如果它回答的是“我怎么做事”</h3>

<p>放进 <code>SOUL.md</code>。</p>

<p>例如：</p>

<ul>
<li>少废话</li>
<li>先查再问</li>
<li>不编造</li>
<li>敏感动作先确认</li>
</ul>


<h3>如果它回答的是“我做什么事”</h3>

<p>放进 <code>AGENTS.md</code>。</p>

<p>例如：</p>

<ul>
<li>默认输出公众号长文和小红书文案</li>
<li>主要平台是公众号和小红书</li>
<li>工作流是收集 → 梳理 → 成文 → 检查 → 复盘</li>
<li>复盘指标优先看阅读和收藏</li>
</ul>


<p>这是区分这两个文件最省脑子的办法。</p>

<h2>五、一个常见误区：把所有东西都堆进 <code>SOUL.md</code></h2>

<p>很多人喜欢把一切“对 Agent 的要求”都堆进 <code>SOUL.md</code>，因为它名字听起来更高级。</p>

<p>但这会带来两个问题：</p>

<ul>
<li><code>SOUL.md</code> 变成一个无边界的大杂烩</li>
<li><code>AGENTS.md</code> 反而变空，只剩一句角色介绍</li>
</ul>


<p>这样做的后果是，Agent 会越来越像“有很多态度，但没什么明确职责”。</p>

<p>反过来也一样。</p>

<p>如果你把所有业务流程和 KPI 都塞进 <code>AGENTS.md</code>，却不定义风格和原则，那 Agent 通常会变成另一个问题：</p>

<ul>
<li>很像流程机器人</li>
<li>但没有稳定的判断框架</li>
<li>做事时容易僵、容易飘、容易忽冷忽热</li>
</ul>


<p>所以真正合理的方式，不是二选一，而是：</p>

<ul>
<li><code>SOUL.md</code> 负责“人格和准则”</li>
<li><code>AGENTS.md</code> 负责“业务和工作”</li>
</ul>


<p>两者配合，Agent 才会既稳定，又有明确产出。</p>

<h2>六、如果你要自己配 Agent，我建议按这个方式写</h2>

<p>最简单的模板可以是这样。</p>

<h3><code>SOUL.md</code></h3>

<p>只保留 4 类：</p>

<ul>
<li>风格</li>
<li>原则</li>
<li>边界</li>
<li>协作偏好</li>
</ul>


<h3><code>AGENTS.md</code></h3>

<p>只保留 5 类：</p>

<ul>
<li>角色</li>
<li>目标</li>
<li>受众 / 平台</li>
<li>工作流</li>
<li>交付物 / KPI</li>
</ul>


<p>如果你按这个思路来写，后面维护会轻松很多。</p>

<p>因为每次新增规则时，你都知道自己是在改：</p>

<ul>
<li>“这个 Agent 的做事方式”</li>
<li>还是“这个 Agent 的业务职责”</li>
</ul>


<p>这两个东西一旦分清，整个 Agent 配置就会明显稳定下来。</p>

<h2>结语</h2>

<p>Agent 配置这件事，表面上看是在写几个 Markdown 文件，本质上其实是在回答两个问题：</p>

<ul>
<li>这个助手应该成为什么样的人？</li>
<li>这个助手应该承担什么样的工作？</li>
</ul>


<p>前一个问题，交给 <code>SOUL.md</code>。</p>

<p>后一个问题，交给 <code>AGENTS.md</code>。</p>

<p>如果你把这两个文件的边界理顺了，后面很多配置问题都会变简单。</p>

<p>因为你终于不是在“堆规则”，而是在真正地设计一个有灵魂、也有岗位职责的 Agent。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[AI Agent 正在进入工程化深水区：从代码模型、生产框架到多智能体协作协议]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/31/ai-agent-engineering-depth/"/>
    <updated>2026-03-31T01:10:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/31/ai-agent-engineering-depth</id>
    <content type="html"><![CDATA[<p>过去一年，围绕 AI Agent 的讨论大多集中在模型能力本身。</p>

<p>但如果把最近几篇有代表性的内容放在一起看，一个更关键的变化已经出现：<strong>AI Agent 的竞争重心，正在从“模型能力展示”转向“工程系统能力”。</strong></p>

<p>这里的“工程系统能力”，不是一句空话。它至少包含四层：</p>

<ul>
<li>面向特定任务优化的模型能力</li>
<li>可接入生产环境的框架能力</li>
<li>能控制复杂度的架构能力</li>
<li>支撑协作扩展的协议能力</li>
</ul>


<p>如果只记一条：<strong>2026 年的 Agent，已经不再只是“大模型 + 工具调用”，而是在走向一套完整的软件工程体系。</strong></p>

<!-- more -->


<h2>一、模型层正在专用化：从“全能模型”转向“任务最优模型”</h2>

<p>以 Cursor 发布 Composer 2 为例，这类发布最容易被表面解读为“又一个新模型上线”。但如果只盯着 benchmark 分数，其实会错过真正重要的信息。</p>

<p>真正值得关注的是：<strong>垂直场景优化，正在从提示词层面的工程技巧，变成底层模型层面的产品策略。</strong></p>

<p>过去大家默认的路径是：</p>

<ul>
<li>先用一个尽可能强的通用模型</li>
<li>再通过 system prompt、工具定义、上下文拼接去适配业务场景</li>
</ul>


<p>而现在，越来越多产品开始反过来做：</p>

<ul>
<li>先承认模型不需要全能</li>
<li>再针对核心任务做专门训练和强化</li>
<li>最后用更低成本、更高稳定性去打场景穿透</li>
</ul>


<p>在代码生成领域，这个逻辑尤其成立。因为对开发者来说，关键指标从来不是“会不会聊天”，而是：</p>

<ul>
<li>多步修改是否稳定</li>
<li>大工程上下文下是否少犯错</li>
<li>工具调用链条是否顺</li>
<li>生成结果是否更接近可运行状态</li>
<li>成本是否足够低，能支撑高频使用</li>
</ul>


<p>所以代码模型的价值，不在于“像人一样懂很多”，而在于“在狭窄但高价值的任务里做到足够可靠”。</p>

<p>从工程视角看，这一步非常重要。因为一旦模型专用化开始成立，系统设计就会自然进入下一阶段：</p>

<ul>
<li>不同任务会使用不同模型</li>
<li>模型之间会形成分工</li>
<li>上层调度必须决定何时调用哪个能力</li>
<li>成本控制开始成为架构问题，而不是单次推理问题</li>
</ul>


<p>一句话：<strong>模型层一旦专用化，Agent 系统就不再是单核结构，而开始具备多能力模块化特征。</strong></p>

<h2>二、框架层正在生产化：企业真正要的不是“聪明”，而是“可治理”</h2>

<p>如果模型层的关键词是“专用化”，那么框架层的关键词就是“生产化”。</p>

<p>以 AgentScope Java 这类框架为代表，可以明显看到一个趋势：<strong>企业级 Agent 框架的卖点，已经从“快速做 Demo”转向“纳入生产治理体系”。</strong></p>

<p>一个 Demo 能跑起来，解决的是“能不能演示”；而一个生产系统能跑下去，解决的是另一组完全不同的问题：</p>

<ul>
<li>能否中断执行</li>
<li>能否保存状态并恢复</li>
<li>能否限制文件、网络、工具访问权限</li>
<li>能否观察中间推理过程</li>
<li>能否记录请求链路和成本</li>
<li>能否融入已有服务体系、监控体系和发布体系</li>
</ul>


<p>这些问题很少出现在社交媒体上的 Agent 演示视频里，但它们决定了系统是否能进入真实业务。</p>

<p>这也是为什么 Java 框架在企业 Agent 讨论里开始重新获得存在感。不是因为 Java 在模型创新上领先，而是因为大量企业核心系统、权限体系、服务治理体系本来就在 Java 世界里。谁更容易接入这些系统，谁就更容易跨过“从试验到生产”的门槛。</p>

<p>从架构角度看，生产化框架至少意味着三件事。</p>

<h3>1）Agent 不再只是一次性调用，而是一个有生命周期的执行体</h3>

<p>它可能被启动、暂停、中断、恢复、观察、接管。这说明 Agent 已经不再是单纯的“函数调用”，而更接近“状态化任务单元”。</p>

<h3>2）Agent 不再只追求最终答案，而要暴露过程</h3>

<p>生产环境里，最终结果固然重要，但更重要的是：</p>

<ul>
<li>它是怎么得出这个结果的</li>
<li>过程中调用了哪些工具</li>
<li>哪一步失败了</li>
<li>到底是模型错了，还是工具错了，还是上下文错了</li>
</ul>


<p>没有过程可见性，就没有治理能力。</p>

<h3>3）Agent 必须服从企业原有系统边界</h3>

<p>企业不会为了 Agent 重写整套权限和运维体系。真正可落地的框架，必须反过来适应既有系统，而不是要求企业围着 Agent 转。</p>

<p>因此，从这一步开始，Agent 就越来越像软件基础设施问题，而不是一个单独的 AI 功能问题。</p>

<h2>三、架构层正在分层化：多智能体不是默认架构，而是复杂度阈值后的选择</h2>

<p>过去一段时间，“多智能体”几乎成了 Agent 讨论里的政治正确。但真正有实践经验的团队，反而越来越强调另一条原则：<strong>Single Agent First。</strong></p>

<p>这个原则看起来保守，其实非常工程化。原因很简单：多智能体架构虽然听起来强大，但它天然会引入新的系统成本：</p>

<ul>
<li>角色划分成本</li>
<li>上下文切分成本</li>
<li>调度链路成本</li>
<li>状态同步成本</li>
<li>调试与排障成本</li>
<li>Token 与时延成本</li>
</ul>


<p>如果业务复杂度还没高到需要这些机制，那么多智能体带来的收益，很可能不足以覆盖它引入的复杂度。</p>

<p>因此，更合理的路径不是“先上多智能体，再想办法降复杂度”，而是：</p>

<ul>
<li>先用单智能体 + 工具解决大多数任务</li>
<li>只有在复杂度跨过阈值时，才引入多角色协作</li>
</ul>


<p>这个“阈值”通常出现在几类场景：</p>

<ul>
<li>上下文无法放进一个窗口</li>
<li>不同职责需要严格隔离</li>
<li>子任务天然适合并行</li>
<li>流程必须分段控制与校验</li>
<li>不同团队需要分别维护不同智能体能力</li>
</ul>


<p>这意味着，多智能体的本质不是“更聪明”，而是更适合处理复杂系统中的职责拆分与流程编排问题。</p>

<p>从这一点看，多智能体更像微服务演进中的服务拆分：</p>

<ul>
<li>在规模小、逻辑简单时，单体更高效</li>
<li>在复杂度上升后，拆分才开始有意义</li>
<li>拆分本身不是目标，控制复杂度才是目标</li>
</ul>


<h2>四、协议层正在标准化：Agent 系统开始进入“协作时代”</h2>

<p>当模型专用化、框架生产化、架构分层化之后，会自然冒出下一个问题：<strong>多个 Agent 之间如何协作？</strong></p>

<p>如果没有标准协议，所谓“多智能体”很容易退化成一种脆弱的私有编排：</p>

<ul>
<li>谁都能发消息，但格式不统一</li>
<li>上下文传递全靠手工拼接</li>
<li>能力授权边界模糊</li>
<li>任务交付物缺少稳定结构</li>
<li>一旦换一个 Agent 实现，协作链路就断掉</li>
</ul>


<p>这也是 A2A 这类协议值得关注的原因。它的价值，不是又发明了一个新缩写，而是试图回答协作系统里最基础的几个问题：</p>

<ul>
<li>如何发现具备特定能力的 Agent</li>
<li>如何把任务以结构化方式委托出去</li>
<li>如何只传递最小必要上下文</li>
<li>如何定义可验证的交付规格</li>
<li>如何在协作过程中进行受控授权</li>
</ul>


<p>这件事为什么重要？因为它标志着“上下文工程”的边界正在上移。</p>

<p>过去谈上下文工程，大家主要关注的是：</p>

<ul>
<li>prompt 怎么写</li>
<li>检索内容怎么塞</li>
<li>tool schema 怎么设计</li>
<li>memory 如何注入</li>
</ul>


<p>但在多 Agent 系统里，这些问题不再只发生在“人和模型之间”，还发生在“Agent 和 Agent 之间”。</p>

<p>于是新的工程问题出现了：</p>

<ul>
<li>哪些上下文应该共享</li>
<li>哪些上下文必须隔离</li>
<li>信息切片粒度如何定义</li>
<li>任务目标如何结构化描述</li>
<li>结果如何自动验收和回流</li>
</ul>


<p>当这些问题成为主问题时，Agent 系统的本质就已经变了。它不再只是“一个大模型加若干外挂工具”，而是在向“分布式协作系统”靠近。</p>

<h2>五、把四层放在一起看：Agent 正在从能力组件变成系统基础设施</h2>

<p>把前面四层连起来，可以看到一条非常清晰的演进链路：</p>

<ul>
<li>模型层专用化，解决特定任务的能力效率问题</li>
<li>框架层生产化，解决生产环境的治理问题</li>
<li>架构层分层化，解决复杂度与职责分工问题</li>
<li>协议层标准化，解决系统扩展与协作问题</li>
</ul>


<p>这四者不是并列关系，而是递进关系。</p>

<p>因为一旦你开始使用专用模型，就会需要调度；一旦你进入调度，就会需要框架与治理；一旦任务复杂度提高，就会需要角色拆分；一旦角色拆分发生，就会需要标准化协作协议。</p>

<p>所以今天讨论 Agent，最容易犯的错误，就是仍然把它理解成一个单点能力增强工具。实际上，它正在逐步变成一套软件系统的基础设施层。</p>

<p>从这个意义上说，<strong>Agent 的下半场竞争，本质上是软件工程能力的竞争。</strong></p>

<h2>六、对技术团队的实际启示</h2>

<p>如果这个判断成立，那么技术团队下一步最值得做的，不是继续沉迷“模型榜单更新”，而是反过来重建自己的落地顺序：</p>

<h3>1）先定义任务，再定义智能</h3>

<p>不要先问“哪个模型最强”，要先问：</p>

<ul>
<li>这个任务到底是问答、执行、编排还是协作</li>
<li>结果是开放式输出，还是结构化交付</li>
<li>容错成本高不高</li>
<li>有没有人工接管点</li>
<li>是否需要审计与追踪</li>
</ul>


<p>没有任务边界，讨论 Agent 架构几乎一定会失真。</p>

<h3>2）先做单智能体闭环，再决定是否升级多智能体</h3>

<p>先验证这几个东西：</p>

<ul>
<li>工具链路是否稳定</li>
<li>上下文设计是否有效</li>
<li>失败主要来自哪里</li>
<li>哪些环节真的需要拆角色</li>
<li>并发是否真的带来收益</li>
</ul>


<p>很多“多智能体需求”，最后会发现其实是“单智能体上下文和工具设计没做好”。</p>

<h3>3）尽早补齐治理面，而不是最后补</h3>

<p>包括：</p>

<ul>
<li>状态保存</li>
<li>权限隔离</li>
<li>中断恢复</li>
<li>过程观测</li>
<li>成本统计</li>
<li>回放与审计</li>
</ul>


<p>这些能力越晚补，代价越大。因为它们通常不是外挂功能，而是会反向影响你的框架选择与系统边界。</p>

<h2>结语</h2>

<p>如果只看单个新闻，最近这些变化看起来是分散的：一个代码模型升级了，一个 Java Agent 框架火了，一篇多智能体选型文章刷屏了，又出现了新的协作协议。</p>

<p>但把它们放在一起，就会看到更本质的趋势：<strong>AI Agent 正在从“可演示的智能能力”，演化成“可治理、可扩展、可协作的软件系统”。</strong></p>

<p>这意味着接下来的竞争，不只是“谁更聪明”，而是：</p>

<ul>
<li>谁的模型更适合任务</li>
<li>谁的框架更适合生产</li>
<li>谁的架构更能控制复杂度</li>
<li>谁的协议更能支撑协作扩展</li>
</ul>


<p>对于真正做落地的人来说，这反而是个好消息。因为从这一刻开始，Agent 不再只是模型厂商的游戏，而重新变成了系统设计者、架构师和工程团队的主战场。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[OpenClaw Gateway 三种对外接口怎么选？]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/24/openclaw-gateway-protocol-comparison/"/>
    <updated>2026-03-24T16:36:02+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/24/openclaw-gateway-protocol-comparison</id>
    <content type="html"><![CDATA[<p>很多团队在接 OpenClaw Gateway 时，第一反应是：到底该用哪个接口？</p>

<p>答案不是“哪个更新就用哪个”，而是看你的目标：是先把能力接入，还是把系统做成可控、可观测、可治理的平台。</p>

<p>如果你只记一条：<strong>Chat Completions 适合快接入，OpenResponses 适合复杂编排，Gateway WS 适合平台控制面。</strong></p>

<p>本文按工程落地视角，把三种协议放到同一张决策图里讲清楚。</p>

<p>先明确一个问题：同一个 Gateway 为什么要提供三种接口？</p>

<p>这是“分层设计”而不是“重复造轮子”——兼容层负责接入效率，原生协议负责控制力与系统治理。</p>

<!-- more -->


<h2>一、三种接口各自解决什么问题</h2>

<h3>1）Gateway 协议（WebSocket）</h3>

<p>这是 OpenClaw 的原生控制面协议。客户端通过 WebSocket 握手（connect），声明 role/scopes/caps，然后以 req/res/event 方式通信。</p>

<p>它最适合做：</p>

<ul>
<li>自研控制台</li>
<li>会话与节点能力统一编排</li>
<li>审批、配置、设备配对、运维级治理</li>
</ul>


<p>一句话：<strong>最完整，但接入门槛最高。</strong></p>

<hr />

<h3>2）OpenAI Chat Completions（<code>/v1/chat/completions</code>）</h3>

<p>这是面向存量生态的兼容接口。你已有 OpenAI SDK 或上层框架时，几乎可以低改造迁移。</p>

<p>它最适合做：</p>

<ul>
<li>快速打通业务链路</li>
<li>验证模型+工具能力</li>
<li>已有 OpenAI 生态资产复用</li>
</ul>


<p>一句话：<strong>上手最快，迁移成本最低。</strong></p>

<hr />

<h3>3）OpenResponses（<code>/v1/responses</code>）</h3>

<p>这是更现代的兼容接口，强调 item 化输入、工具回合、多模态输入（文件/图片）和更细颗粒度的流式事件。</p>

<p>它最适合做：</p>

<ul>
<li>复杂工具调用回合</li>
<li>多模态上下文输入</li>
<li>需要更强可观测事件流的 Agent 系统</li>
</ul>


<p>一句话：<strong>语义更完整，适合复杂场景。</strong></p>

<hr />

<h2>二、工程决策矩阵（可直接拿去评审）</h2>

<h3>维度 1：接入复杂度</h3>

<ul>
<li>最低：Chat Completions</li>
<li>中等：OpenResponses</li>
<li>最高：Gateway WS</li>
</ul>


<h3>维度 2：生态兼容性</h3>

<ul>
<li>最强：Chat Completions</li>
<li>次之：OpenResponses</li>
<li>最弱（但可控性最高）：Gateway WS</li>
</ul>


<h3>维度 3：工具与回合表达能力</h3>

<ul>
<li>Chat Completions：够用，偏经典函数调用形态</li>
<li>OpenResponses：更适合复杂工具回合与结构化交互</li>
<li>Gateway WS：可做全链路控制与事件编排</li>
</ul>


<h3>维度 4：可观测性与治理</h3>

<ul>
<li>Chat Completions：偏业务调用视角</li>
<li>OpenResponses：事件语义更细，观测更自然</li>
<li>Gateway WS：控制面最完整，适合平台治理</li>
</ul>


<h3>维度 5：长期演进空间</h3>

<ul>
<li>Chat Completions：适合作为入口层</li>
<li>OpenResponses：适合作为复杂业务主接口</li>
<li>Gateway WS：适合作为平台核心控制面</li>
</ul>


<hr />

<h2>三、三类典型团队该怎么选</h2>

<h3>场景 A：你要“这周上线”</h3>

<p>选 Chat Completions。</p>

<p>原因：复用现有 SDK，改造最小，最快出结果。</p>

<h3>场景 B：你要“复杂 Agent 工作流”</h3>

<p>选 OpenResponses。</p>

<p>原因：输入输出语义更现代，工具回合、多模态、事件流更顺手。</p>

<h3>场景 C：你要“公司级 AI 平台控制面”</h3>

<p>选 Gateway WS。</p>

<p>原因：只有原生协议能把角色、权限、节点能力、审批、配置纳入一套统一治理模型。</p>

<hr />

<h2>四、推荐落地路径（避免一步到位翻车）</h2>

<h3>Phase 1：先用 Chat Completions 跑通业务闭环</h3>

<p>目标：验证价值，不纠结架构完美。</p>

<h3>Phase 2：把复杂链路迁到 OpenResponses</h3>

<p>目标：提升工具编排能力和事件可观测性。</p>

<h3>Phase 3：控制治理能力下沉到 Gateway WS</h3>

<p>目标：统一权限、审批、配置与节点编排，做成平台而不是脚本集合。</p>

<hr />

<h2>五、生产防坑清单</h2>

<ol>
<li><strong>协议选型不要脱离组织能力</strong>：团队不会维护 WS 客户端，就别上来就全量 WS。</li>
<li><strong>先定义会话键与幂等策略</strong>：没有幂等，重试就是事故放大器。</li>
<li><strong>日志字段跨协议统一</strong>：requestId/sessionKey/runId 必须统一，才能追踪问题。</li>
<li><strong>权限边界先于功能边界</strong>：先做“能不能做”，再做“做什么更快”。</li>
<li><strong>演进路线写进技术方案</strong>：短期兼容层、长期控制面，避免每次重构都推倒重来。</li>
</ol>


<hr />

<h2>结语</h2>

<p>OpenClaw Gateway 三种接口不是替代关系，而是分层协作关系。</p>

<p>对工程团队来说，真正重要的不是“选哪个最先进”，而是：</p>

<ul>
<li>当前阶段怎么最快交付价值</li>
<li>下一阶段怎么平滑升级</li>
<li>最终怎么形成可控、可观测、可治理的平台能力</li>
</ul>


<p>这才是协议选型的终局。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[Agent 落地不靠更强模型：后端团队先补这 4 个治理动作]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/18/agent-governance-for-backend-teams/"/>
    <updated>2026-03-18T21:00:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/18/agent-governance-for-backend-teams</id>
    <content type="html"><![CDATA[<p>最近一轮知识库信息放在一起看，结论很清楚：
Agent 已经从“能不能做”进入“能不能稳定做、持续做、规模做”。</p>

<p><strong>真正决定成败的，不是模型上限，而是工程治理下限。</strong></p>

<p>很多团队现在都能把 Agent 跑起来：接 IM、调工具、跑自动化流程。
但一上真实业务就出问题：串会话、误操作、成本飙升、结果不可复盘。
这类问题本质上不是 Prompt 问题，而是系统边界没有建好。</p>

<!-- more -->


<h2>一、会话与并发治理：先保证可预测，再谈性能</h2>

<p>第一步不是提并发，而是先把并发“关进笼子”：</p>

<ul>
<li>同会话串行执行，避免上下文串台</li>
<li>消息队列策略固定（collect / followup）</li>
<li>设置会话排队上限、超时与丢弃规则</li>
</ul>


<p>如果这一层没做，业务一上量就会出现“同一用户前后文互相污染”，后面所有优化都白做。</p>

<h2>二、工具权限治理：把“会执行”变成“可控执行”</h2>

<p>Agent 接了终端、文件、外部 API 后，风险不再是“答错一句话”，而是“做错一件事”。</p>

<p>必须落地三件事：</p>

<ul>
<li>工具最小权限（默认 deny）</li>
<li>高风险动作审批（删除、外发、系统修改）</li>
<li>审计日志留痕（谁在何时执行了什么）</li>
</ul>


<p>没有这层，任何一次误调用都可能直接变生产事故。</p>

<h2>三、稳定性与成本治理：把失败设计成默认路径</h2>

<p>生产环境里，失败不是例外，是常态。
要提前把“故障时怎么继续”设计好：</p>

<ul>
<li>模型/密钥 fallback 链</li>
<li>限流与错误指数退避</li>
<li>上下文压缩 + 工具结果修剪</li>
</ul>


<p>目标只有一个：在坏环境下还能跑，不把服务打穿。</p>

<h2>四、内容运营治理：把一次经验变成团队资产</h2>

<p>纯技术落地如果不转成“可复用内容”，团队学习曲线会重复踩坑。</p>

<p>建议固定复盘模板：</p>

<ul>
<li>本次问题与触发条件</li>
<li>处置动作与回滚策略</li>
<li>可复用检查项</li>
<li>下一次默认配置</li>
</ul>


<p>技术治理 + 内容沉淀同时做，才能形成长期复利。</p>

<h2>上线前最小检查清单（可直接执行）</h2>

<ul>
<li>[ ] 会话边界明确，DM/群聊不串台</li>
<li>[ ] 队列策略配置并压测通过</li>
<li>[ ] 工具最小权限与审批生效</li>
<li>[ ] 关键执行链路可审计</li>
<li>[ ] 模型故障有 fallback 与退避</li>
<li>[ ] 上下文与成本可观测</li>
<li>[ ] 复盘模板落盘并可复用</li>
</ul>


<h2>结语</h2>

<p>Agent 落地不是“再接一个模型”，而是“先建一套护栏”。
先把系统变成可控工程，再把效率放大。
这一步做对了，后面才是真正的规模化红利。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[OpenClaw多Agent方案]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/12/openclaw-multi-agent-architecture/"/>
    <updated>2026-03-12T01:50:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/12/openclaw-multi-agent-architecture</id>
    <content type="html"><![CDATA[<p>很多团队把 Agent 做到第二阶段都会遇到同一个问题：</p>

<ul>
<li><p>单个 Agent 已经不够用，要拆“角色分工”。</p></li>
<li><p>一台机器放不下所有任务，要跨多台主机部署。</p></li>
<li><p>代理之间需要通信协作，但又不能互相污染上下文。</p></li>
</ul>


<p>这篇文章基于 OpenClaw 官方文档，系统讲清四件事：<strong>单机多 Agent 怎么搭</strong>、<strong>单主机多 OpenClaw 实例何时可用</strong>、<strong>多 OpenClaw 主机怎么协作</strong>、<strong>代理间如何通信才稳定可控</strong>。</p>

<!-- more -->


<h2>1. 先统一心智模型：OpenClaw 的多 Agent 不是“多人格提示词”</h2>

<p>在 OpenClaw 里，一个 agent 本质是一个“完整隔离单元”，它拥有自己的：</p>

<ul>
<li><p>workspace（包括 AGENTS.md/SOUL.md/USER.md 与本地文件上下文）</p></li>
<li><p>agentDir（认证与 agent 级状态）</p></li>
<li><p>sessions（会话与路由状态）</p></li>
</ul>


<p>所以“多 Agent”是工程级隔离，而不是同一上下文里改几段提示词。</p>

<hr />

<h2>2. 单机多 Agent：推荐的标准架构</h2>

<p>先给结论：<strong>一个 Gateway + 多个 agent + 显式 bindings 路由</strong> 是官方推荐范式。</p>

<h3>2.1 架构骨架</h3>

<ul>
<li><p>一台主机只跑一个 Gateway（官方架构约束）。</p></li>
<li><p>Gateway 持有所有渠道连接（Telegram/WhatsApp/Slack/&hellip;）。</p></li>
<li><p>通过 <code>bindings</code> 把不同 channel/account/peer 的入站消息，确定性路由到不同 agent。</p></li>
<li><p>每个 agent 使用独立 workspace 和 agentDir，避免认证与会话冲突。</p></li>
</ul>


<h3>2.2 最小配置示例（单机多 Agent）</h3>

<figure class='code'><div class="highlight"><table><tr><td class="gutter"><pre class="line-numbers"><span class='line-number'>1</span>
<span class='line-number'>2</span>
<span class='line-number'>3</span>
<span class='line-number'>4</span>
<span class='line-number'>5</span>
<span class='line-number'>6</span>
<span class='line-number'>7</span>
<span class='line-number'>8</span>
<span class='line-number'>9</span>
<span class='line-number'>10</span>
<span class='line-number'>11</span>
<span class='line-number'>12</span>
<span class='line-number'>13</span>
<span class='line-number'>14</span>
<span class='line-number'>15</span>
<span class='line-number'>16</span>
<span class='line-number'>17</span>
<span class='line-number'>18</span>
<span class='line-number'>19</span>
<span class='line-number'>20</span>
<span class='line-number'>21</span>
<span class='line-number'>22</span>
<span class='line-number'>23</span>
<span class='line-number'>24</span>
<span class='line-number'>25</span>
<span class='line-number'>26</span>
<span class='line-number'>27</span>
<span class='line-number'>28</span>
<span class='line-number'>29</span>
<span class='line-number'>30</span>
</pre></td><td class='code'><pre><code class=''><span class='line'>{
</span><span class='line'>  "agents": {
</span><span class='line'>    "list": [
</span><span class='line'>      {
</span><span class='line'>        "id": "assistant",
</span><span class='line'>        "default": true,
</span><span class='line'>        "workspace": "~/.openclaw/workspace-assistant",
</span><span class='line'>        "agentDir": "~/.openclaw/agents/assistant/agent"
</span><span class='line'>      },
</span><span class='line'>      {
</span><span class='line'>        "id": "research",
</span><span class='line'>        "workspace": "~/.openclaw/workspace-research",
</span><span class='line'>        "agentDir": "~/.openclaw/agents/research/agent"
</span><span class='line'>      }
</span><span class='line'>    ]
</span><span class='line'>  },
</span><span class='line'>  "bindings": [
</span><span class='line'>    {
</span><span class='line'>      "agentId": "research",
</span><span class='line'>      "match": {
</span><span class='line'>        "channel": "telegram",
</span><span class='line'>        "peer": { "kind": "direct", "id": "tg:123456789" }
</span><span class='line'>      }
</span><span class='line'>    },
</span><span class='line'>    {
</span><span class='line'>      "agentId": "assistant",
</span><span class='line'>      "match": { "channel": "telegram" }
</span><span class='line'>    }
</span><span class='line'>  ]
</span><span class='line'>}</span></code></pre></td></tr></table></div></figure>


<h3>2.3 单机模式下的通信方式</h3>

<p>同一 Gateway 内，agent 间协作优先走 session 工具：</p>

<ul>
<li><p><code>sessions_send</code>：向另一个 session 发消息并等待结果（可超时控制）。</p></li>
<li><p><code>sessions_spawn</code>：派生隔离子代理执行长任务，完成后回传摘要。</p></li>
</ul>


<p>这两类通信在同一 Gateway 内是“内生通信”，上下文边界更清晰、可追踪性更好。</p>

<h3>2.4 单主机多 OpenClaw 实例：可做，但要明确边界</h3>

<p>有些团队会在同一台机器上启动多个 OpenClaw 进程（而不是一个 Gateway 托管多个 agent）。这个方案不是主路径，但在“强隔离”诉求下可用。</p>

<p>适用场景：</p>

<ul>
<li><p>你需要把不同业务线彻底隔离到不同进程生命周期。</p></li>
<li><p>你希望为不同实例配置不同端口、不同状态目录、不同系统服务策略。</p></li>
</ul>


<p>必须满足的工程约束：</p>

<ul>
<li><p>每个实例使用独立 <code>OPENCLAW_STATE_DIR</code>。</p></li>
<li><p>每个实例使用独立 Gateway 端口（避免 WS/HTTP 端口冲突）。</p></li>
<li><p>每个实例的 channel 账号登录状态独立管理，避免同账号并发占用。</p></li>
<li><p>每个实例独立 workspace/agentDir，避免会话与认证污染。</p></li>
</ul>


<p>实践建议：如果目标只是“多人格/多角色协作”，优先选择<strong>单 Gateway + 多 agent + bindings</strong>。只有当你明确需要“进程级隔离”时，再采用单主机多实例。</p>

<hr />

<h2>3. 多 OpenClaw 主机：现实可用的 3 种协作拓扑</h2>

<p>这里最容易误解：<strong>OpenClaw 官方当前核心是“单 Gateway 控制面”</strong>。跨主机协作不是默认内建成“跨 Gateway 透明 RPC”。</p>

<p>所以工程上要用“桥接层”把多主机连起来。</p>

<h3>3.1 拓扑 A：渠道桥接（推荐起步）</h3>

<ul>
<li><p>Host-A 的 agent 通过消息渠道（如 Telegram Bot/群）发任务。</p></li>
<li><p>Host-B 作为另一个 OpenClaw 实例在同渠道接收并处理。</p></li>
<li><p>处理结果再通过渠道回发到 Host-A 或人工会话。</p></li>
</ul>


<p>优点：部署快，稳定性高，几乎不用改 OpenClaw 内核。</p>

<h3>3.2 拓扑 B：Webhook / Hook 事件桥接</h3>

<ul>
<li><p>Host-A 将任务打包成结构化事件（JSON）投递给 Host-B 的接收端。</p></li>
<li><p>Host-B 的 Hook/入口会话消费事件并触发 agent 执行。</p></li>
<li><p>回传可走 webhook 回调或消息渠道。</p></li>
</ul>


<p>优点：便于与现有后端系统集成，适合平台化。</p>

<h3>3.3 拓扑 C：外部任务总线桥接（企业场景）</h3>

<ul>
<li><p>两台 OpenClaw 通过外部队列/任务系统（如 Redis Streams、Kafka、SQS）解耦。</p></li>
<li><p>OpenClaw 只做“智能执行器”，任务编排交给外部工作流层。</p></li>
</ul>


<p>优点：吞吐与治理能力最好，但实施复杂度最高。</p>

<hr />

<h2>4. 代理间通信与协作：建议采用“分层协议”</h2>

<h3>4.1 协作协议（建议）</h3>

<ul>
<li><p>控制消息：任务编号、优先级、超时、重试策略。</p></li>
<li><p>业务消息：输入参数、上下文摘要、期望输出格式。</p></li>
<li><p>回执消息：状态（accepted/running/done/failed）、结果摘要、错误分类。</p></li>
</ul>


<h3>4.2 角色分工（建议）</h3>

<ul>
<li><p>Orchestrator Agent：接任务、拆解、派发、汇总。</p></li>
<li><p>Worker Agent：按契约执行单一子任务。</p></li>
<li><p>Reviewer Agent：做一致性检查与质量门禁。</p></li>
</ul>


<h3>4.3 三条硬规则</h3>

<ul>
<li><p><strong>幂等键</strong>：每个任务都要有业务 id，重复投递可安全去重。</p></li>
<li><p><strong>超时与降级</strong>：<code>sessions_send</code>/外部桥接必须有 timeout 与 fallback。</p></li>
<li><p><strong>上下文最小化</strong>：跨代理只传“必要上下文 + 结构化结果”，不要整段历史硬转发。</p></li>
</ul>


<h3>4.4 协议补充：A2A（Google Agent2Agent）与 ANP（Agent Network Protocol）</h3>

<p>在跨系统、跨组织的多代理协作里，可以把 OpenClaw 作为运行时，把 A2A/ANP 当作“外部互联协议层”。</p>

<ul>
<li><p><strong>A2A（Agent2Agent）</strong>：Google 发起的开放互操作协议，强调任务生命周期、能力发现（Agent Card）、长任务状态同步，以及基于 HTTP / SSE / JSON-RPC 的标准化通信。</p></li>
<li><p><strong>ANP（Agent Network Protocol）</strong>：国内社区推动的开源协议，重点放在开放网络中的智能体身份与安全通信（例如 DID 身份、认证与加密通道）。</p></li>
</ul>


<p>一个实用落地方式：</p>

<ul>
<li><p>OpenClaw 内部（同 Gateway 或同实例）优先用 <code>sessions_send</code> / <code>sessions_spawn</code>。</p></li>
<li><p>OpenClaw 与外部 Agent 平台协作时，可通过桥接层接入 A2A。</p></li>
<li><p>在跨组织、需要身份自治与安全互信的场景，可评估引入 ANP 作为身份与通信补充层。</p></li>
</ul>


<p>注意：协议选型要看你的治理边界——企业内统一平台优先 A2A 生态兼容，开放网络互联优先关注 ANP 的身份与安全模型成熟度。</p>

<hr />

<h2>5. 实操中的常见坑</h2>

<ul>
<li><p>把多个 agent 复用同一个 <code>agentDir</code>，导致认证/会话冲突。</p></li>
<li><p>bindings 规则不够具体，出现“路由命中漂移”。</p></li>
<li><p>把跨主机协作当成同机 <code>sessions_send</code>，结果通信链路设计不完整。</p></li>
<li><p>没有幂等，重试时重复执行副作用（重复发消息/重复写库）。</p></li>
<li><p>没有统一状态模型，排障时看不到“任务卡在哪一跳”。</p></li>
</ul>


<hr />

<h2>6. 给团队的落地建议（从 0 到 1）</h2>

<ul>
<li><p>第一步：先在单机把“多 Agent + bindings + sessions_spawn”跑顺。</p></li>
<li><p>第二步：引入一种跨主机桥接（先渠道桥接，再升级 webhook/队列）。</p></li>
<li><p>第三步：补齐治理（幂等、重试、审计、告警、权限边界）。</p></li>
</ul>


<p>这样做的好处是：每一步都可验证，不会把复杂度一次性打满。</p>

<hr />

<h2>7. 总结</h2>

<p>OpenClaw 的多 Agent 架构要点可以压缩成一句话：</p>

<blockquote><p><strong>同机协作用 Gateway 内生会话工具，跨机协作用外部桥接层；隔离、路由、幂等是稳定性的三根柱子。</strong></p></blockquote>

<p>如果你正在做多代理系统，不要先追求“最智能”，先把“能稳定协作”做出来。</p>

<hr />

<h2>参考资料（权威来源）</h2>

<ul>
<li><p>OpenClaw 官方文档：Gateway Architecture<br/>
<a href="https://docs.openclaw.ai/concepts/architecture">https://docs.openclaw.ai/concepts/architecture</a></p></li>
<li><p>OpenClaw 官方文档：Multi-Agent Routing<br/>
<a href="https://docs.openclaw.ai/concepts/multi-agent">https://docs.openclaw.ai/concepts/multi-agent</a></p></li>
<li><p>OpenClaw 官方文档：Session Tools（sessions_send / sessions_spawn）<br/>
<a href="https://docs.openclaw.ai/concepts/session-tool">https://docs.openclaw.ai/concepts/session-tool</a></p></li>
<li><p>OpenClaw 官方文档：Sub-Agents<br/>
<a href="https://docs.openclaw.ai/tools/subagents">https://docs.openclaw.ai/tools/subagents</a></p></li>
<li><p>OpenClaw 官方文档：Configuration Reference<br/>
<a href="https://docs.openclaw.ai/gateway/configuration-reference">https://docs.openclaw.ai/gateway/configuration-reference</a></p></li>
<li><p>Google Developers Blog：Announcing the Agent2Agent Protocol (A2A)<br/>
<a href="https://developers.googleblog.com/en/a2a-a-new-era-of-agent-interoperability/">https://developers.googleblog.com/en/a2a-a-new-era-of-agent-interoperability/</a></p></li>
<li><p>A2A 协议官方文档（Linux Foundation 托管）<br/>
<a href="https://a2a-protocol.org/latest/">https://a2a-protocol.org/latest/</a></p></li>
<li><p>ANP 官方文档（中文）<br/>
<a href="https://www.agent-network-protocol.com/zh/guide/">https://www.agent-network-protocol.com/zh/guide/</a></p></li>
<li><p>ANP 身份与加密通信层<br/>
<a href="https://agentnetworkprotocol.com/docs/concepts/identity/">https://agentnetworkprotocol.com/docs/concepts/identity/</a></p></li>
</ul>

]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[OpenClaw 架构剖析]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/03/openclaw-architecture/"/>
    <updated>2026-03-03T00:15:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/03/openclaw-architecture</id>
    <content type="html"><![CDATA[<p>上一篇聊了「OpenClaw 是什么」。这一篇更偏工程视角：<strong>OpenClaw 到底怎么实现一个可长期运行的 Agent 系统？消息是怎么进来的？怎么路由到 Agent？工具调用与定时任务如何编排？</strong></p>

<p>如果你做过 Agent 落地，会很熟悉这些关键词：channel、tool、session、cron、memory、安全边界、幂等、观测……OpenClaw 的价值在于把这些抽象成一套可部署的 runtime。</p>

<!-- more -->


<h2>1. OpenClaw 由哪些模块组成？</h2>

<p><img src="https://www.rowkey.cn/post_images/openclaw/arch.jpg" width="450"/></p>

<p>你可以把 OpenClaw 想成三层：</p>

<p>1) <strong>接入层（Channels）</strong>：连接外部世界（Telegram/钉钉/QQ/…），负责收消息、发消息。</p>

<p>2) <strong>编排层（Gateway + Routing + Sessions）</strong>：决定“这条消息交给哪个 Agent/哪个会话”，并维护状态与生命周期。</p>

<p>3) <strong>执行层（Agents + Tools/Skills + Jobs）</strong>：Agent 负责决策，Tools 负责执行，Jobs（cron 等）负责触发。</p>

<p>对应到工程实体，大致是：</p>

<blockquote><p>关键约束（和官方架构一致）：<strong>一台主机一个 Gateway</strong>、<strong>连接首帧必须是 <code>connect</code> 握手</strong>、<strong>事件流默认不回放（客户端需自行补拉状态）</strong>。</p></blockquote>

<ul>
<li><strong>Gateway（守护进程）</strong>：常驻运行，连接多个 channel provider，维护连接与重连。</li>
<li><strong>Channel Plugin</strong>：每个渠道一个适配器，实现 inbound/outbound。</li>
<li><strong>WebChat/UI 客户端</strong>：本质是通过 WebSocket 连接 Gateway 的控制平面客户端。</li>
<li><strong>Agent</strong>：可配置多个（不同模型/不同工作空间/不同权限），按路由绑定到渠道。</li>
<li><strong>Session</strong>：把对话与任务上下文组织起来（类似“对话线程 + 状态机”）。</li>
<li><strong>Skills</strong>：可复用的工具说明与脚本集合，给 Agent 一个“可靠使用工具”的方法。</li>
<li><strong>Cron/Jobs</strong>：把定时触发变成一等公民，支持隔离执行、送达与可配置去重策略。</li>
<li><strong>Memory</strong>：长期/短期记忆（以文件记忆为主 + 语义检索），为跨会话连续性服务。</li>
</ul>


<h2>2. 核心流程 1：一条消息从“外部”到“Agent”的路径</h2>

<p>把它拆成 8 步，你会发现它是一条典型的事件驱动流水线：</p>

<p>1) <strong>Channel 收到事件</strong></p>

<ul>
<li>可能是文本、图片、语音、文件、按钮回调等。</li>
</ul>


<p>2) <strong>插件标准化（Normalize）</strong></p>

<ul>
<li>把不同平台的 message schema 归一：from/to/messageId/timestamp/chatType/attachments…</li>
</ul>


<p>3) <strong>封装输入（Envelope）</strong></p>

<ul>
<li>给 Agent 一个稳定的“输入格式”，避免每个渠道都写一套提示词。</li>
</ul>


<p>4) <strong>路由（Routing/Binding）</strong></p>

<ul>
<li>根据规则把消息交给指定 agent（例如 QQ 走 hang-ai，Telegram 走 main）。</li>
</ul>


<p>5) <strong>会话选择（Session Key）</strong></p>

<ul>
<li>同一用户/群聊映射到固定 session，确保上下文连续。</li>
</ul>


<p>6) <strong>Agent 推理（Decide）</strong></p>

<ul>
<li>Agent 选择：直接回复，还是调用工具（搜索/执行/写文件/定时任务）。</li>
</ul>


<p>7) <strong>工具执行（Tools/Skills）</strong></p>

<ul>
<li>工具是“副作用层”：读写文件、访问网络、调用 API、跑命令。</li>
</ul>


<p>8) <strong>回传与发送（Outbound Deliver）</strong></p>

<ul>
<li>将 Agent 结果交给 channel 插件发送，处理分段、markdown、富媒体等。</li>
</ul>


<blockquote><p>这条链路里，最容易做坏的其实是第 2～5 步：输入不干净、路由不清晰、session 混乱，都会让 Agent “聪明但不稳定”。OpenClaw 的设计重点正是在这里。</p></blockquote>

<h2>3. 核心流程 2：工具调用如何“可靠地执行”？</h2>

<p>一个可落地的 Agent 系统，工具调用必须具备三种属性：</p>

<h3>3.1 可控（Controllable）</h3>

<ul>
<li>工具入口有限且明确（不是什么都能 exec）。</li>
<li>敏感能力要有策略（allowlist/denylist/人工确认）。</li>
</ul>


<h3>3.2 可观测（Observable）</h3>

<ul>
<li>能看到：调用了什么工具、参数是什么、耗时多久、失败原因。</li>
<li>能复盘：某次输出是怎么来的。</li>
</ul>


<h3>3.3 可恢复（Recoverable）</h3>

<ul>
<li>失败要能重试/降级（例如 web fetch 失败就换来源）。</li>
<li>长链路要能分段（先产出，再补充）。</li>
</ul>


<p>OpenClaw 的 skill 机制，本质是在做“<strong>把提示词工程变成可维护的工程资产</strong>”。你不希望每次靠大模型临场发挥写一堆 shell；你希望它遵循一个稳定的脚本与约定。</p>

<h2>4. 核心流程 3：Cron/Jobs（定时任务）为什么是 Agent 生产化的关键？</h2>

<p>很多 Agent 项目死在“能对话，但不能跑”。原因是：</p>

<ul>
<li>任务不能准点触发</li>
<li>不能隔离执行（被主会话上下文污染）</li>
<li>失败后没有送达保障</li>
<li>会重复发送（没有幂等）</li>
</ul>


<p>OpenClaw 的 cron 设计可以抽象成：</p>

<ul>
<li><strong>触发器（schedule）</strong>：cron / every / at</li>
<li><strong>执行体（payload）</strong>：systemEvent 或 agentTurn（隔离会话跑）</li>
<li><strong>投递（delivery）</strong>：把结果发到指定 channel/target</li>
<li><strong>幂等/去重</strong>：通常用 state 文件（last_date/last_hash）或业务键</li>
</ul>


<blockquote><p>一个很实用的经验：<strong>凡是“每天推送/定时汇总/提醒”的任务，都要把幂等写成硬性要求</strong>。这比“写得更聪明”重要得多。</p></blockquote>

<h2>5. 语音/图片等多媒体：为什么“把内容注入正文”很关键？</h2>

<p>以语音为例，很多系统会把语音转写结果作为“附件描述”塞进消息里，但 Agent 可能把它当噪声过滤掉，最后表现为“不回复”。</p>

<p>更可靠的做法是：</p>

<ul>
<li>语音 → 转写</li>
<li><strong>把转写文本当作用户输入正文</strong>（例如前缀“（语音转写）xxx”）</li>
<li>同时保留附件元信息（可选）：文件路径、时长、来源</li>
</ul>


<p>这其实是一条通用原则：</p>

<blockquote><p><strong>Agent 真正在乎的是“它以为用户说了什么”。</strong> 所以多模态处理的结果要进入“正文层”，而不是“旁注层”。</p></blockquote>

<h2>6. 可复用的方法论：如何用 OpenClaw（或任何 Agent Runtime）做出稳定的系统？</h2>

<p>下面这套方法论与 OpenClaw 强相关，但本质上是通用的 Agent 工程原则。</p>

<h3>方法论 1：把 Agent 系统拆成“决策层 vs 执行层”</h3>

<ul>
<li>决策层：LLM/Agent（可变、概率性）</li>
<li>执行层：脚本/工具/skill（确定性、可测试）</li>
</ul>


<p>越早把副作用收敛到执行层，你的系统越稳。</p>

<h3>方法论 1.5：模块化优先——Plugin 与 Skill 是“可加载的工程单元”</h3>

<p>很多 Agent 项目后期会失控，本质原因是：所有能力都堆在一个巨大的代码/提示词里，无法升级、无法替换、也无法复用。</p>

<p>OpenClaw 的架构里有两个非常值得复用的抽象：</p>

<ul>
<li><strong>Plugin（插件）</strong>：面向“渠道/外部系统”的适配层。它把不稳定、强耦合的外部差异隔离掉（消息格式、鉴权、富媒体、限流、重连…）。</li>
<li><strong>Skill（技能）</strong>：面向“工具使用”的可维护模块。它把“如何调用某个工具”沉淀成文档/脚本/约定，让 Agent 可靠执行。</li>
</ul>


<p>你在研发其他项目时可以照搬这套思想：</p>

<ul>
<li><strong>把所有 I/O 做成插件接口</strong>（inbound/outbound 都走统一协议）</li>
<li><strong>把执行能力做成可装卸的模块</strong>（每个模块有清晰的输入输出契约）</li>
<li><strong>把运行时策略配置化</strong>（允许按项目/按环境切换能力组合）</li>
</ul>


<p>这样系统才具备“长期演进能力”：</p>

<ul>
<li>想换搜索引擎/供应商？替换 skill 即可。</li>
<li>想多接一个渠道？加一个 plugin，不影响核心。</li>
<li>想做权限收敛？在 runtime/策略层统一控制。</li>
</ul>


<h3>方法论 2：事件驱动 + 明确的状态机</h3>

<p>你会发现 OpenClaw 的心智模型很像：
- event in → route → session → agent → tools → deliver</p>

<p>这其实就是一个状态机。把“会话键/幂等键/任务键”定义清楚，系统就会稳定。</p>

<h3>方法论 2.5：把“配置”当成系统契约（Contract），而不是参数堆</h3>

<p>OpenClaw 里很多稳定性来自于“约束前置”：</p>

<ul>
<li>绑定规则（哪个 channel → 哪个 agent）</li>
<li>工具权限（哪些 tool 可用/哪些 elevated 禁止）</li>
<li>推送策略（cron 的去重文件、重试退避）</li>
</ul>


<p>工程上你可以把它抽象成：</p>

<ul>
<li><strong>配置即策略</strong>：把可变决策（谁能做什么、什么时候做）从代码里拿出来。</li>
<li><strong>配置可审计</strong>：出现事故时能追溯“当时允许了什么”。</li>
<li><strong>配置可迁移</strong>：换环境/换机器/换团队时，复制配置即可复现能力。</li>
</ul>


<h3>方法论 3：任何自动推送都必须幂等</h3>

<p>推荐最低配：</p>

<ul>
<li><code>last_date</code>（今天发过就退出）</li>
<li><code>last_hash</code>（内容一致就退出）</li>
</ul>


<p>把它当成产品级需求，而不是“优化项”。</p>

<h3>方法论 4：先做可观测，再做智能</h3>

<p>一个很反直觉的点：</p>

<ul>
<li>你以为“让模型更聪明”能解决问题</li>
<li>实际上，80% 的线上问题来自：超时、失败重试、权限、消息格式、平台限制</li>
</ul>


<p>所以先把日志、运行记录、失败原因打通，后面再谈“更聪明”。</p>

<h3>方法论 5：安全边界要前置</h3>

<p>建议至少做到：</p>

<ul>
<li>渠道 allowlist / groupPolicy</li>
<li>敏感工具禁用或需要确认</li>
<li>不信任外部内容（把网页/邮件当不可信输入）</li>
</ul>


<p>Agent 的安全不是模型能解决的，是架构要解决的。</p>

<h2>7. 总结</h2>

<p>OpenClaw 的架构并不神秘：它把 Agent 的生产化问题拆解为一组工程模块（channel、session、tool、cron、memory、安全策略），并把“核心流程”做成可运行、可观测、可扩展的系统。</p>

<p>如果你要复用它的方法论，记住一句话就够：</p>

<blockquote><p><strong>让 LLM 做决策，让系统做约束，让工具做执行。</strong></p></blockquote>

<p>这就是把 Agent 从 demo 推向长期运行系统的关键。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[OpenClaw 是什么]]></title>
    <link href="https://www.rowkey.cn/blog/2026/03/01/openclaw/"/>
    <updated>2026-03-01T00:00:00+08:00</updated>
    <id>https://www.rowkey.cn/blog/2026/03/01/openclaw</id>
    <content type="html"><![CDATA[<p>这两年大家对「Agent」的讨论越来越多：能自动查资料、能写代码、能跑流程、还能定时汇总。但真要把它放进日常工作流，会立刻遇到几个现实问题：<strong>它怎么和你的消息渠道连起来？怎么定时？怎么拿到你本机/服务器的上下文？怎么安全地执行命令？怎么长期稳定运行？</strong></p>

<p>OpenClaw 解决的不是“再做一个聊天机器人”，而是把这些“让 Agent 变成生产力”的工程问题打包成一套可部署、可扩展的运行时。</p>

<!-- more -->


<h2>1. OpenClaw 到底是什么？</h2>

<p>一句话：<strong>OpenClaw 是一个面向个人/团队的 Agent 运行时（Agent Runtime）</strong>。</p>

<p>它更像一个“智能操作系统/中枢”，把三件事连接起来：</p>

<p>1) <strong>你的输入输出渠道（Channels）</strong>：比如 Telegram、钉钉、QQ、Slack…你在哪里说话，它就在哪里接收与回复。</p>

<p>2) <strong>可执行的工具系统（Tools/Skills）</strong>：不仅是“搜索”，还包括：跑脚本、读写文件、定时任务、发消息、抓网页、处理媒体、接入第三方服务等。</p>

<p>3) <strong>Agent 的会话与状态（Sessions/Memory/Jobs）</strong>：把对话、任务、定时推送、长期记忆等组织起来，能持续运行、可追踪、可回放。</p>

<p>从使用感受上，它像一个“你自己的 AI 助理平台”，而不是单次问答。</p>

<h2>2. 为什么会出现 OpenClaw？（解决 Agent 落地的 4 个痛点）</h2>

<h3>2.1 只靠 Chat，不够</h3>

<p>把大模型当聊天工具，最多做到“回答问题”。但现实工作更像“完成任务”：</p>

<ul>
<li>每天 10:00 推送 AI 新闻</li>
<li>监控某些关键词/博客更新</li>
<li>把语音转文字、把图片转摘要</li>
<li>在你允许的情况下执行命令、生成文件、提交仓库</li>
</ul>


<p>这些都需要一个稳定的执行层。</p>

<h3>2.2 工具碎片化，拼起来很痛</h3>

<p>你可以用各种 bot、脚本、cron、Webhook、爬虫、自动化平台……但拼在一起时，常见问题是：</p>

<ul>
<li>触发点分散（消息、定时、网页变化）</li>
<li>状态难管理（重复发送、幂等、去重）</li>
<li>缺少统一的权限与审计</li>
<li>失败重试、降级策略没人兜底</li>
</ul>


<p>OpenClaw 的定位就是把这些“胶水层”标准化。</p>

<h3>2.3 Agent 需要“能跑得起来”的生命周期</h3>

<p>Agent 不应该只存在于一次对话里，而应该具备：</p>

<ul>
<li><strong>可持续运行</strong>（daemon/service）</li>
<li><strong>可定时触发</strong>（cron jobs）</li>
<li><strong>可隔离执行</strong>（isolated sessions）</li>
<li><strong>可观察</strong>（日志、运行记录、失败原因）</li>
</ul>


<h3>2.4 更重要的是：安全边界</h3>

<p>Agent 一旦能执行命令、能发消息、能访问外部链接，就一定会遇到：</p>

<ul>
<li>prompt injection（内容里夹带指令）</li>
<li>权限扩大（工具链越接越多越危险）</li>
<li>数据泄露（日志、外发、第三方 API）</li>
</ul>


<p>OpenClaw 的思路是：把工具权限、通道策略、定时任务、敏感能力控制放进同一套配置与运行时里。</p>

<h2>3. 怎么使用 OpenClaw？（一个最小心智模型）</h2>

<p>OpenClaw 里你可以把系统理解成：</p>

<ul>
<li><strong>Gateway（网关/守护进程）</strong>：负责连接各个 channel、接收消息、派发给 agent、把回复送回去。</li>
<li><strong>Agent（智能体）</strong>：负责“思考与决策”，选择调用哪些工具。</li>
<li><strong>Skills（技能）</strong>：一套可复用的“说明 + 脚本 + 约定”，让 agent 可靠地使用工具。</li>
<li><strong>Cron（定时任务）</strong>：把“每天/每小时/某个时刻做事”变成一等公民。</li>
</ul>


<p>一个典型的工作流是：</p>

<p>1) 你在 Telegram/钉钉/QQ 里发一句话：</p>

<blockquote><p>“每天 10 点给我推送 AI 新闻”</p></blockquote>

<p>2) Agent 把它变成一个 cron job（带去重与失败重试）。</p>

<p>3) 到点了 cron 自动触发，agent 做检索→整理→发送消息。</p>

<p>4) 你觉得格式不对，再要求调整；之后就稳定每天按你的格式推送。</p>

<h2>3.5 一个“最小 Quickstart”（不追求完美，只求跑通）</h2>

<p>如果你只想快速体验 OpenClaw 的核心价值，可以按这个顺序：</p>

<p>1) <strong>选一个入口渠道</strong>：先接 Telegram/钉钉/QQ 其中一个（你日常最常用的）。</p>

<p>2) <strong>跑通一条闭环任务</strong>：例如“每天 10:00 推送 AI 新闻”。</p>

<p>3) <strong>把输出格式固定下来</strong>：标题、条目数量、每条的字段（描述/日期/链接）。</p>

<p>4) <strong>加入幂等/去重</strong>：同一天已发送就退出（避免重复轰炸）。</p>

<p>5) <strong>再逐步加技能</strong>：比如从“新闻推送”升级到“跟踪你的关注源 + 只推相关内容”。</p>

<p>这一套的关键是：<strong>先让系统进入稳定运行状态</strong>，而不是一上来追求大而全。</p>

<h2>4. OpenClaw 能做哪些场景？（从轻到重）</h2>

<h3>4.1 信息获取与整理</h3>

<ul>
<li>每日 AI/科技新闻推送（可指定来源、语言、数量、格式）</li>
<li>监控 RSS/博客更新（发现新文章就提醒）</li>
<li>追踪某个领域的关键词（模型发布、投融资、政策）</li>
</ul>


<h3>4.2 沟通与会议辅助</h3>

<ul>
<li>语音消息自动转写 + 生成纪要</li>
<li>多轮对话里的 TODO 提取与跟踪</li>
<li>帮你写邮件/公告/总结，统一口吻</li>
</ul>


<h3>4.3 工程与开发工作流</h3>

<ul>
<li>代码库问答、PR 说明、变更总结</li>
<li>自动生成文档/模板（比如周报、复盘、技术方案）</li>
<li>结合 GitHub CLI 做 issue/PR 维护（在权限允许时）</li>
</ul>


<h3>4.4 你的“个人自动化中枢”</h3>

<ul>
<li>定时行情（BTC/黄金/宏观指标）</li>
<li>定时提醒（喝水、会议前提醒、月底结算）</li>
<li>把零散工具串成稳定流程（抓取→处理→分发）</li>
</ul>


<h3>4.5 两个“最像生产力”的 Demo（建议你自己也这么配）</h3>

<p><strong>Demo 1：每日新闻推送（带去重）</strong></p>

<ul>
<li>触发：每天 10:00</li>
<li>动作：检索过去 24h 的 AI/科技新闻 → 按固定模板输出 10 条 → 发送到钉钉/Telegram</li>
<li>关键点：写入 <code>last_date</code>/<code>last_hash</code> 做幂等；发送失败有退避重试</li>
</ul>


<p><strong>Demo 2：语音消息→转写→直接回复</strong></p>

<ul>
<li>触发：你在聊天里发一条语音</li>
<li>动作：自动下载语音文件 → 转码（如 AMR/SILK→WAV）→ Whisper 转写 → 把转写文本当作“用户输入正文”让 Agent 回复</li>
<li>关键点：如果只把转写当作“附件描述”，很多 Agent 会把它当噪声忽略；要注入到正文里。</li>
</ul>


<h2>5. 一些实践建议（把它用成生产力，而不是玩具）</h2>

<p>1) <strong>先从一个强需求开始</strong>：例如“每天 10 点新闻推送”。从 0 到 1 跑通，价值立刻可见。</p>

<p>2) <strong>格式标准化</strong>：输出要固定模板，后面才能自动化复用。</p>

<p>3) <strong>幂等与去重</strong>：定时推送必须有“今天已发则退出”的逻辑。</p>

<p>4) <strong>给 Agent 明确的权限边界</strong>：哪些能访问、哪些不能执行，越早设定越省心。</p>

<p>5) <strong>把它当成一个长期系统</strong>：日志、状态文件、失败重试、降级策略都要有。</p>

<h2>6. 总结</h2>

<p>OpenClaw 的价值在于：它让 Agent 具备“能接入你真实工作流、能长期稳定运行、能安全执行工具”的工程底座。</p>

<p>当你不再把 AI 当成一次性问答，而是当成一个可以持续协作的“数字员工/助理”，你需要的就不是一个聊天窗口，而是一套运行时——这就是 OpenClaw 为什么会出现。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[2026 年 AI 最新进展]]></title>
    <link href="https://www.rowkey.cn/blog/2026/02/26/ai-progress-2026/"/>
    <updated>2026-02-26T16:00:00+00:00</updated>
    <id>https://www.rowkey.cn/blog/2026/02/26/ai-progress-2026</id>
    <content type="html"><![CDATA[<p>截至文章发布时间（2026-02-26），2026 年 AI 的关键变化不再是“又出了一个更强的模型”，而是 <strong>多模态内容生成、Agent 工程化、可交付系统</strong> 这三件事在同一时期快速叠加，让 AI 从“能演示”走向“能交付”。</p>

<p>这篇文章不做流水账式盘点，而是选 3 个热度高、信号明确的事件作为锚点：<strong>Seedance 2.0（视频）</strong>、<strong>OpenClaw（Agent 系统）</strong>、<strong>Genie3（世界模型/交互式生成）</strong>。基于这些事件，再抽象出一套更可复用的产品化方法论：怎么把 AI 能力沉到工程系统里，做成长期可运营的生产力。</p>

<!-- more -->


<h2>1. 三个高热度事件（截至 2026-02-26）</h2>

<h3>1.1 Seedance 2.0：视频生成开始对齐“工业交付”和“导演级可控”</h3>

<p>Seedance 2.0 的信号意义不在于“又一个视频模型”，而在于它把注意力放在 <strong>可控性与交付链路</strong>：</p>

<ul>
<li>统一的多模态音视频联合生成架构，支持文字/图片/音频/视频输入</li>
<li>强调运动稳定性、物理规律还原、原生音画同步（视听体验）</li>
<li>面向广告/影视/社媒营销场景的链路适配：输出质量对齐工业交付标准、降低成本、提升效率</li>
</ul>


<p>它代表视频生成的竞争从“能生成”走向“能按需求生成、能被工作流接住、能进入生产链路”。</p>

<p>数据来源：
- <a href="https://seed.bytedance.com/zh/seedance2_0">https://seed.bytedance.com/zh/seedance2_0</a></p>

<h3>1.2 OpenClaw 出圈：Agent 从“能力展示”走向“可运营系统”</h3>

<p>OpenClaw 的热度值得作为一个产品化信号来理解：它并不是提出了新模型，而是把一套 Agent 工程结构做成了可运行、可迭代、可维护的系统形态（通道、自动化、工具操作、长任务执行等）。</p>

<p>其核心价值不在“模型更聪明”，而在于把 AI 能力组织成了工程系统所需要的形状：可配置、可观测、可回放、可重试、可治理。</p>

<p>（公开报道提及 OpenClaw/Clawdbot 的现象与影响）</p>

<p>数据来源：
- <a href="https://www.news.cn/world/20260203/a173cb66c98a4b1bb551d588fd2f0209/c.html">https://www.news.cn/world/20260203/a173cb66c98a4b1bb551d588fd2f0209/c.html</a></p>

<h3>1.3 Genie3：世界模型与可交互生成进入“工具化”阶段</h3>

<p>除了内容生成与 Agent，2026 年一个值得关注的方向是：模型不仅生成内容，也在尝试生成“可交互环境”。公开报道提到，基于世界模型 Genie 3 的工具向公众开放，用户可以通过自然语言描述创建并探索可交互的三维虚拟世界。</p>

<p>它的信号意义在于：生成式 AI 的产品形态，开始从“出一段内容”走向“生成一个可探索/可操作的环境”，为游戏、仿真、训练与数字孪生等方向带来新变量。</p>

<p>数据来源：
- <a href="https://www.news.cn/world/20260203/a173cb66c98a4b1bb551d588fd2f0209/c.html">https://www.news.cn/world/20260203/a173cb66c98a4b1bb551d588fd2f0209/c.html</a></p>

<hr />

<h2>2. 基于事件抽象：从模型到产品化的方法论</h2>

<p>这三个事件看似分散，但背后其实收敛成同一套规律：<strong>把 AI 当作工程系统的一部分，而不是一个会聊天的黑盒</strong>。</p>

<h3>2.1 可控性优先：从“生成效果”走向“可交付结果”</h3>

<p>Seedance 2.0 强调“导演级操控与工业交付”，OpenClaw 强调“能跑、能闭环”，共同指向一个结论：</p>

<ul>
<li>重要的不再是“偶尔很强”，而是“稳定在预算和 SLA 内完成任务”</li>
<li>重要的不再是“单次结果”，而是“端到端交付成本”</li>
<li>重要的不再是“输出”，而是“过程可约束、可纠错、可回放”</li>
</ul>


<p>工程上对应的抓手一般是：结构化输出、工具调用、失败模式分析、回放与重试。</p>

<h3>2.2 先 Workflow，后 Agent：把智能放在流程关键节点</h3>

<p>OpenClaw 这类系统能跑进真实环境，一个关键原因是：它更像“可维护工作流 + 智能节点”的组合，而不是“把所有步骤都交给一个大模型”。</p>

<p>更稳的落地路径是：</p>

<ul>
<li>先把流程打通：触发、采集、处理、分发、回执、追踪</li>
<li>再把 Agent 放在关键节点（判断/生成/归纳/编排）</li>
<li>逐步扩大边界，而不是一开始就赌“全自动超级 Agent”</li>
</ul>


<h3>2.3 配置即契约：把不确定性关进笼子</h3>

<p>当系统要长期运行、并且会遇到重试、定时、跨系统同步时，最重要的不是“提示词更强”，而是把关键约束写成契约并强制执行：</p>

<ul>
<li>输出格式契约（字段、模板、是否只发一条）</li>
<li>幂等契约（last_date / last_hash / url_hash 去重键）</li>
<li>失败与重试策略（退避、次数上限、同文本重发）</li>
<li>权限边界（哪些工具可用、哪些动作需要人工确认）</li>
</ul>


<p>没有契约，就没有可维护性；没有可维护性，就没有规模化。</p>

<h3>2.4 多模态落地的关键是“管道”，不是“炫技”</h3>

<p>Seedance 2.0 这类模型强调工业交付，本质上对工程提出了更硬的要求：格式、编码、超时、重试、质量评估、审计追踪。</p>

<p>多模态真正落地通常离不开：</p>

<ul>
<li>输入输出规范化（格式、时长、分辨率）</li>
<li>资源与时间预算（超时控制、排队策略）</li>
<li>可追溯（素材、prompt、参数、版本）</li>
<li>质量评估与抽检（对齐业务 KPI，而不是论文指标）</li>
</ul>


<h3>2.5 世界模型的产品化前提：可交互 + 可控 + 可评估</h3>

<p>Genie3 这类方向如果要产品化，除了“能生成”，还需要三件事：</p>

<ul>
<li>可交互：环境不是静态内容，而是可探索、可操作</li>
<li>可控：约束生成边界，保证一致性与稳定性</li>
<li>可评估：定义指标（任务成功率、物理一致性、用户体验等），能迭代优化</li>
</ul>


<p>这也再次回到同一个核心：能力提升很重要，但决定能否落地的，往往是工程系统如何承接它。</p>

<hr />

<h2>结语</h2>

<p>截至 2026-02-26，我更愿意把今年 AI 的主线称为“工程化的胜利”：</p>

<ul>
<li>内容生成在对齐工业交付</li>
<li>Agent 在对齐闭环执行与可运营性</li>
<li>世界模型在尝试走向交互式工具化</li>
</ul>


<p>接下来一年，决定胜负的可能不是“谁的模型强 3 分”，而是：</p>

<blockquote><p>谁能把 AI 做成一套可维护、可扩展、可协作、可审计的工程系统。</p></blockquote>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[AI大事记@2025]]></title>
    <link href="https://www.rowkey.cn/blog/2025/12/27/ai-2025/"/>
    <updated>2025-12-27T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2025/12/27/ai-2025</id>
    <content type="html"><![CDATA[<p>接近2025年底，概括总结了一下2025这一年的一些AI关键事件。</p>

<!-- more -->


<table>
<thead>
<tr>
<th style="text-align:left;"> 时间 </th>
<th style="text-align:left;"> 事项 </th>
<th style="text-align:left;"> 备注 </th>
</tr>
</thead>
<tbody>
<tr>
<td style="text-align:left;"> <strong>2025.12.16</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT-Image-1.5</strong> </td>
<td style="text-align:left;"> 不管是从零生成，还是对图片进行局部编辑，更接近你脑子里想的那个结果；并且生成速度最高可达 4 倍提升。实测：比配套Nano Banana Pro强。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.12.11</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT 5.2</strong> </td>
<td style="text-align:left;"> GPT-5.2 能够在真实复杂工作流程中高效协作，从代码分析、财务建模、工程设计，到研究论文分析、实验结果推理，都能提供高质量辅助。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.11.21</strong> </td>
<td style="text-align:left;"> <strong>Google Nano Banana Pro</strong><br><em>(aka Gemini 3.0 Pro Image)</em> </td>
<td style="text-align:left;"> 全球首个“推理至像引擎”，不仅是绘画，更是理解物理规律与空间逻辑。作为 Nano Banana 的旗舰升级版，它像人类一样“思考”和“规划”场景，生成前所未有的逻辑一致性，完美文本和高分辨率的视觉作品。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.11.16</strong> </td>
<td style="text-align:left;"> <strong>Google Gemini 3.0 pro</strong> </td>
<td style="text-align:left;"> 全面高刷。同时发布Antigravity 编程IDE，生成式前端UI能力遥遥领先，可以快速实现各种交互式H5应用。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.11.12</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT 5.1</strong> </td>
<td style="text-align:left;"> 将GPT-5 和 GPT-5 Mini 合并为一个能适应问题难度的自适应调整思考用量的模型。相比GPT5，语气更亲切、更幽默，更善于遵循指令。整体性能介于GPT-5 和 GPT-5 Mini 之间。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.10.16</strong> </td>
<td style="text-align:left;"> <strong>Google Veo 3.1</strong> </td>
<td style="text-align:left;"> 主打更强叙事与音频控制、音乐韵律与多参考图拼接，接入 Gemini API与Vertex AI。Flow与Gemini可用。可合成多人物场景、语音同步，片段最长约146秒；规格至1080p/24fps。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.10.01</strong> </td>
<td style="text-align:left;"> <strong>OpenAI Sora2</strong> </td>
<td style="text-align:left;"> 非常好的物理世界理解能力，同时推出了Sora APP，定位AI短影音。号称视频领域的GPT-3.5时刻。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.09.09</strong> </td>
<td style="text-align:left;"> <strong>字节发布 Seedream 4.0</strong> </td>
<td style="text-align:left;"> 定位“生成与编辑一体化”专业工具。编辑能力强甚至部分超过nano banana。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.27</strong> </td>
<td style="text-align:left;"> <strong>Google Nano Banana</strong><br><em>(aka Gemini 2.5 Flash Image)</em> </td>
<td style="text-align:left;"> 具有极好的编辑能力，能够多图融合、强一致性，替代GPT4o成为图片编辑的王者。SOTA of 图像模型。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.26</strong> </td>
<td style="text-align:left;"> <strong>通义万相 Wan2.2-S2V-14B</strong> </td>
<td style="text-align:left;"> 一个可以跑动的14B视频模型，仅需一张图片和一段音频，即可生成面部表情自然、口型一致、肢体动作丝滑的电影级叙事/人视频。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.26</strong> </td>
<td style="text-align:left;"> <strong>即梦AI智能多模</strong> </td>
<td style="text-align:left;"> 传统的拼接是两个团队，各干各的，最后硬拼在一起。而堆叠多帧是一个全真全参数带上下文的团队，大家各让一步处理，因此能做到四宽的一致性。堆叠多帧背后的底层逻辑：即一体的全局考虑。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.21</strong> </td>
<td style="text-align:left;"> <strong>GenSpark AI Designer</strong> </td>
<td style="text-align:left;"> 一款革命性的AI设计工具，能够一键生成完整的多屏设计方案，涵盖Logo、包装、网站设计等多个领域，极大地降低了设计门槛。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.20</strong> </td>
<td style="text-align:left;"> <strong>DeepSeek V3.1</strong> </td>
<td style="text-align:left;"> 代码能力极高，但文本能力并未提高，甚至有某些下降。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.19</strong> </td>
<td style="text-align:left;"> <strong>Qwen-Image-Edit</strong> </td>
<td style="text-align:left;"> 全能图像编辑。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.08</strong> </td>
<td style="text-align:left;"> <strong>OpenAI GPT5</strong> </td>
<td style="text-align:left;"> 一个统一的系统，包含一个能够解决大多数问题的智能快速模型、一个能够解决复杂长问题的深度推理模型，以及一个实时语音器。可以根据对话类型、复杂性、工具需求判断意图并快速决定使用哪个模型。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.06</strong> </td>
<td style="text-align:left;"> <strong>OpenAI 开源模型</strong><br>GPT-oss-120b和GPT-oss-20b </td>
<td style="text-align:left;"> 性能与兼容性兼具，非英文表现不好。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.05</strong> </td>
<td style="text-align:left;"> <strong>Google Genie3</strong> </td>
<td style="text-align:left;"> 新一代生成式世界模型——Genie3。根据文本创造一个可以实时交互的世界。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.08.04</strong> </td>
<td style="text-align:left;"> <strong>Qwen-image</strong> </td>
<td style="text-align:left;"> 通义千问团队开源的首个图像生成基础模型，在解决传统文生图模型文字渲染难题上实现了突破性进展，尤其在中文场景下表现突出。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.07.23</strong> </td>
<td style="text-align:left;"> <strong>Qwen3-coder</strong> </td>
<td style="text-align:left;"> 拥有卓越的代码Agent能力，在Agentic Coding、Agentic Browser-Use 和 Foundational Coding Tasks 上均取得了开源模型的 SOTA 效果。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.07.12</strong> </td>
<td style="text-align:left;"> <strong>Kimi K2</strong> </td>
<td style="text-align:left;"> 将模型权重代码全量开源。大模型竞技场LMArena排行榜中，Kimi K2综合排名斩获全球第五，在开源大模型中位居全球第一。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.07.09</strong> </td>
<td style="text-align:left;"> <strong>xAI Grok 4</strong> </td>
<td style="text-align:left;"> 极其激进的快速迭代。推出 Grok 4 Heavy，引入多智能体架构，针对复杂科研任务优化，算力规模再创新高。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.07.05</strong> </td>
<td style="text-align:left;"> <strong>Gemini CLI</strong> </td>
<td style="text-align:left;"> 开源命令行界面工具，它将谷歌强大的 Gemini AI 模型直接集成到开发者常用的终端环境中，更擅长服务于编程。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.07.02</strong> </td>
<td style="text-align:left;"> <strong>Flux图像模型</strong><br>Kontext Dev模型正式开始 </td>
<td style="text-align:left;"> 强一致性、强理解力。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.06.24</strong> </td>
<td style="text-align:left;"> <strong>Imagen4</strong> </td>
<td style="text-align:left;"> 显著改善文本渲染效果，进一步提升了文本转图像的生成质量。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.06.22</strong> </td>
<td style="text-align:left;"> <strong>Gemini 2.5 Flash/Pro</strong> </td>
<td style="text-align:left;"> </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.06.11</strong> </td>
<td style="text-align:left;"> <strong>Seedance1.0</strong> </td>
<td style="text-align:left;"> 字节跳动推出的一款高性能和推理极致的视频语言生成模型。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.05.23</strong> </td>
<td style="text-align:left;"> <strong>Claude code</strong> </td>
<td style="text-align:left;"> 智能化辅助写代码工具，旨在帮助开发者通过自然语言命令理解、浏览和修改整个代码库，前端编程领域无人能敌。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.05.21</strong> </td>
<td style="text-align:left;"> <strong>Veo3</strong> </td>
<td style="text-align:left;"> 首个可生成视频背景音效模型，体会画面感、配合感、生成人物对话，物理模拟与口型同步表现优异。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.04.29</strong> </td>
<td style="text-align:left;"> <strong>Qwen3</strong> </td>
<td style="text-align:left;"> 国产最强开源模型。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025年5月</strong> </td>
<td style="text-align:left;"> <strong>Loverr设计Agent</strong> </td>
<td style="text-align:left;"> 2025年7月28日正式上线。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.04.05</strong> </td>
<td style="text-align:left;"> <strong>Meta Llama 4</strong> </td>
<td style="text-align:left;"> Meta发布开源模型 Llama 4（包含Scout和Maverick版本）。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.03.26</strong> </td>
<td style="text-align:left;"> <strong>GPT4o改图能力</strong> </td>
<td style="text-align:left;"> 一致性能力好，响应慢。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.03.06</strong> </td>
<td style="text-align:left;"> <strong>通用Agent</strong><br>Manus, GenSpark, Flowith </td>
<td style="text-align:left;"> </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.02.17</strong> </td>
<td style="text-align:left;"> <strong>xAI Grok 3</strong> </td>
<td style="text-align:left;"> Elon Musk 发布 Grok 3，宣称其为“地球上最聪明的AI”。 </td>
</tr>
<tr>
<td style="text-align:left;"> <strong>2025.01.20</strong> </td>
<td style="text-align:left;"> <strong>DeepSeek R1</strong> </td>
<td style="text-align:left;"> 国产开源推理模型，媲美OpenAI o1。 </td>
</tr>
</tbody>
</table>

]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[《太白金星有点烦》读后感]]></title>
    <link href="https://www.rowkey.cn/blog/2025/08/25/taibaijinxing/"/>
    <updated>2025-08-25T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2025/08/25/taibaijinxing</id>
    <content type="html"><![CDATA[<p>最近利用出差在高铁和飞机上的时间，读完了《太白金星有点烦》这本书。总体感觉挺有意思的，作者用诙谐的笔法把现代职场政治、官僚主义与古典神话《西游记》完美融合，让人真觉得西游记是不是就是这么回事。当然，这些感觉之余也在时刻对照目前公司中是否有这些问题，所幸民营企业也不敢这么搞，万幸万幸。</p>

<!-- more -->


<h3>一、 内容梗概</h3>

<p>故事从<strong>太白金星（李长庚）</strong>的视角展开。在书中，原本宏大的“西天取经”不再是一场纯粹的弘扬佛法之旅，而是一项由天庭和西天联合开发、层层外包的<strong>“重点项目”</strong>。</p>

<ol>
<li><strong>项目经理李长庚：</strong> 李长庚被任命为西游项目的“策划人”和“协调员”。他的任务是确保玄奘一行人经历九九八十一难，且每一难都要有记录、有预算、有排场，还要兼顾各方势力的利益。</li>
<li><strong>职场琐事：</strong> 书中详细描写了李长庚如何处理那些令人头大的“行政工作”：如何给有背景的妖怪安排出场机会又不能真伤了取经人；如何跨部门沟通（天庭与西天的地盘之争）；如何报销差旅费；以及如何处理各种突发的公关危机。</li>
<li><strong>取经的真相：</strong> 随着项目的推进，李长庚发现所谓“九九八十一难”大多是人为安排的“走秀”。而在这背后，隐藏着更深层的权力斗争和资源分配。</li>
<li><strong>结局与悟道：</strong> 在经历了无数职场洗礼后，李长庚在项目结束时面临着“修成正果”的选择。他最终对权力和成仙有了全新的理解，完成了一种精神上的自我救赎。</li>
</ol>


<h3>二、 核心评价与书评</h3>

<h4>1. 绝佳的职场隐喻（“神仙也得写周报”）</h4>

<p>马伯庸最天才的地方在于他把<strong>“仙界”写成了“职场”</strong>。
*   <strong>层级森严：</strong> 佛祖和玉帝是大BOSS，菩萨和星君是中层领导，李长庚是资深项目经理。
*   <strong>潜规则：</strong> 没背景的妖怪一棒打死，有背景的妖怪被主人接走。书中将这种《西游记》原本的讽刺进一步具体化为：如何写汇报材料才能既掩盖错误又突出业绩。
*   <strong>读者的共鸣：</strong> 每一个打工人都能在李长庚身上看到自己——为了KPI奔波，在领导的暗示中揣摩意图，在繁琐的流程中消耗生命。</p>

<h4>2. 对《西游记》的解构与重组</h4>

<p>这本书不仅仅是恶搞，它对原著细节的挖掘极其深厚。
*   它解释了为什么有的关卡漏洞百出，为什么神仙的坐骑总是“不小心”走失。
*   通过李长庚的视角，作者重新审视了孙悟空、猪八戒等人的形象。孙悟空不再只是单纯的叛逆者，而是被纳入体制内、必须学会配合演出的“高级顾问”。</p>

<h4>3. 悲悯的底色与“修心”</h4>

<p>虽然表面上充满了幽默和讽刺，但书的内核是有些<strong>致郁且深刻</strong>的。
*   李长庚在算计了一辈子后，感到了一种深深的疲惫和荒诞感。
*   <strong>“超脱”：</strong> 最终李长庚的悟道，不是因为累积了多少功德，而是他看穿了这套体制的虚伪，选择回归自我的本真。这种从“入世”到“出世”的转变，给现代职场人提供了一种心理上的抚慰。</p>

<h4>4. 文字风格</h4>

<p>马伯庸的文字极其流畅，充满了“马式冷幽默”。他擅长用现代公文词汇去描述神仙对话，产生了一种强烈的反差萌。例如，把因果报应说成“利益分配”，把降妖伏魔说成“外勤任务”。</p>

<hr />

<h3>三、 总结：为什么要读这本书？</h3>

<ul>
<li><strong>如果你是职场人：</strong> 你会一边笑一边流泪，感叹“马伯庸是在我工位下装了监控吗？”</li>
<li><strong>如果你是西游迷：</strong> 你会惊叹于原著竟然还能被这样解读，每一个细节都严丝合缝。</li>
<li><strong>如果你想寻找慰藉：</strong> 它会告诉你，在繁杂的世俗规则中，如何保有一颗不被磨灭的初心。</li>
</ul>


<p><strong>一句话简评：</strong>
这是一部披着神话外衣的职场生存指南，也是一首写给所有疲惫灵魂的解脱之诗。它告诉我们：<strong>“成仙”不在于位次的高低，而在于能否在满地鸡毛的生活中，找回那个清醒的自己。</strong></p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[DeepSeek简单分享]]></title>
    <link href="https://www.rowkey.cn/blog/2025/02/23/deepseek/"/>
    <updated>2025-02-23T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2025/02/23/deepseek</id>
    <content type="html"><![CDATA[<p>本文内容来自一次内部分享。主要是对目前非常火的DeepSeek的一些自己的认知和理解。</p>

<!-- more -->


<h2>DeepSeek是什么？</h2>

<p>DeepSeek是一个由中国公司推出的媲美ChatGPT o1能力的开源推理大模型，其中文能力更强，而且由于背后公司数据的特点，在金融方面具有优势。</p>

<p>这里所说的推理大模型是相对于之前的非推理模型，更加强化了推理、逻辑分析和决策能力，可以看做是把之前的CoT能力直接做到了模型里。</p>

<p>DeepSeek本身是包括V3和R1两个模型，参数都达到6000亿，也就是现在市面上很多人说的满血版。而DeepSeek开源的几个蒸馏版本的模型其实本质还是qwen和llama，只是用了R1的推理数据做了微调。</p>

<h2>DeepSeek生态位</h2>

<p>综合了各种榜单和一些评测，并基于公司实际使用的经验，对现在主流的大模型做了如下梯队排名：</p>

<p><img src="https://www.rowkey.cn/post_images/deepseek/dp_rank.png" width="450"/></p>

<p>在选择模型时需要注意：</p>

<ul>
<li>开源模型可以私有化部署提供无审查的服务</li>
<li>国内模型在中文上有优势</li>
</ul>


<p>通过这个梯度，也可以看到DeepSeek并不是能力最强的，但R1确实是国内最好的推理模型。而非推理模型国内的通义千问是能力最强的。这里需要提到的一点就是Kimi其实也和DeepSeek差不多同一时间推出了推理模型的，能力也没有差太多，但由于不是完全开源的，所以被DeepSeek给完全盖住了。</p>

<h2>DeepSeek为什么这么火?</h2>

<p>如第一部分所说，本质上DeepSeek是一个中国公司做到了O1水平并且开源了的推理大模型。具体来说，之所以它这么火有以下几点：</p>

<ul>
<li>ChatGPT o1出来后，给业界出了一道题，然后DeepSeek给解出来了，并且是以低成本的方式实现了，甚至还给开源了。</li>
<li>对于国内来说，由于zz原因，很长一段时间是无法使用国外的第一梯队大模型的。所以，有了DeepSeek这种能用的模型，自然是迅速出圈。</li>
<li>对于国外来说，则是高估了领先中国的速度，低估了中国的追赶速度。</li>
</ul>


<h2>为什么是DeepSeek?</h2>

<p>国内外很多大模型厂商，为什么是DeepSeek做出来了呢？</p>

<ul>
<li>DeepSeek背后是幻方量化，这家公司号称多内私募量化四巨头，非常赚钱，有一年就捐了3个亿做慈善。虽然DeepSeek是相对独立的一家公司，但其中的关联肯定小不了，所以大概率是不缺钱的，也不是奔着赚钱去的。因此，可以类似高校一样单纯的做研究。与之相比，Kimi就有商业化的诉求，所以能看到Kimi在大量的投放广告。</li>
<li>DeepSeek的招人门槛很高，虽然创始人是浙大的，但团队成员基本上是清北级别的。</li>
<li>DeepSeek曾号称有国内最多的A100显卡。</li>
<li>创始人梁文峰是很有技术追求的一个人，不管是量化还是大模型，据各种报道，都是自己亲身在一线写代码、写论文的。</li>
<li>我自己的认知，其实OpenAI推出o1后，大家都在研究，都在探索，方法也都有区别，DeepSeek这次做出来是有一点运气成分。</li>
</ul>


<p>这里还想提的是，春节期间所谓的国运一说，我觉得如果DeepSeek在不长的时间能追上甚至超过o3，那真的可以说国运了。</p>

<h2>DeepSeek的创新</h2>

<p>DeepSeek由于受限于显卡的性能（H800），通过工程优化上的创新提升了算法效率，从而也大大降低了成本。</p>

<ul>
<li>DeepSeekMoE：采用了大量细粒度的专家，因此推理时，能大幅降低成本。</li>
<li>负载均衡优化：采用Auxiliary-loss-free算法提高了MoE路由的效率。</li>
<li>内存优化：重计算、使用CPU内存和参数共享</li>
<li>通信优化：DualPipe</li>
<li>计算优化：FP8混合精度训练</li>
<li>其他：MLA(多头潜在注意力)、MTP（多Token预测）、GPRO（强化学习算法）等</li>
<li>NSA：原生稀疏注意力，长文本能力</li>
</ul>


<h2>使用</h2>

<p>推理模型是有使用场景的，适合需要深度思考的场景，如设计、审查、推理、复杂计算等。如果让其做一些简单的任务，如实现代码，可能会思考来思考去，反而降低效率。结合推理模型+非推理模型是现在一种常用的方式，如DeepSeek R1 + Claude 3.5 sonnet就是使用R1来做方案设计，使用Claude来写代码。</p>

<p>不同于之前的非推理模型，推理模型的提示词跟侧重于描述清楚任务目标，过多的引导反而是干扰。</p>

<p>此外，通过DeepSeek对蒸馏模型的证明，一些行业模型也可以通过DeekSeek R1的推理数据来微调，实现蒸馏的效果。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[美国AI之旅]]></title>
    <link href="https://www.rowkey.cn/blog/2024/06/05/usa-ai/"/>
    <updated>2024-06-05T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2024/06/05/usa-ai</id>
    <content type="html"><![CDATA[<p>5月底去了一趟旧金山，和一些华人AI科学家进行了交流，也参加了旧金山由GPTDao和微软联合举办的GenAI大会。这里输出一些收获。</p>

<!-- more -->


<ol>
<li>一个华人科学家分享他们团队在做消费级设备（车载、手机）大模型的创业。苹果最近发布的Apple Intelligence也是类似的思路。之前陈天奇团队做的mlc-llm同样是在做这样的事情，再结合特斯拉的FSD也是基于Transformer的自动驾驶决策，这个方向还是很有机会的。但国内貌似很少听到类似的项目。</li>
<li>Amino: 一家华人创办的VC公司。看到他们投的一家针对美国移民多这一特点的电商平台，每个国家的人进去看到都是来自这个国家的商品，这个估计只有美国是合适的。另外，他们也分享了目前硅谷还是创业者导向的，一个好的创业项目，需要投资人去争取。这家公司的创始人有个抖音号叫硅谷李师傅，在持续分享硅谷的一些东西。</li>
<li>Meta AI：分享了Meta大模型方面的进展，印象比较深刻的是实时图像生成，可以边输入提示词，边生成图像。网址：<a href="https://www.meta.ai/?icebreaker=imagine">https://www.meta.ai/?icebreaker=imagine</a></li>
<li>Tesla：分享了他们在自动驾驶方面的进展。特斯拉的FSD不同于目前主流自动驾驶技术的是使用了基于Transformer的驾驶决策，通过使用保险公司大量驾驶分数好的司机的数据来训练这个模型，对比Waymo基于激光雷达，成本会低非常多。但受限于保密的原因，其他有干货的东西感觉不是很多。</li>
<li>Nvidia: 分享了他们正在开发的多模态大模型。自己这次发现英伟达虽然主要精力在芯片，但其实也在大量地做各种AI模型层、应用层的尝试，包括后来在GenAI会议上Jim Fan讲的具身智能，这里有这个分享的总结：<a href="https://mp.weixin.qq.com/s/DF0GBx99vodq0dYM98iRFA%E3%80%82">https://mp.weixin.qq.com/s/DF0GBx99vodq0dYM98iRFA%E3%80%82</a></li>
<li>听了Google科学家讲述Google在多模态大模型方面的进展。印象比较深的一点，就是现在业界对小公司的包容度大，对大公司包容度小，因此经常会放大谷歌的问题，某种维度上是不公平的。</li>
<li>硅谷的人才流动很频繁，没有什么绝对的技术壁垒，而且硅谷是没有竞业协议的。所以，OpenAI的优势并没有那么绝对。目前谷歌已经从OpenAI挖回来了不少大模型人才。</li>
<li>旧金山GenAI Summit 2024

<ul>
<li>硅谷这边各种小的应用都能支撑起一家创业公司，比如会场在用的otter.ai就是实时记录会议内容，和钉钉、飞书的闪记的功能是一样的。</li>
<li>华人团队做的天机阁AI测算，这个是我们公司比较关注的一个赛道，天机阁的应用体验做的很一般，但测算的体验确实不错。应该是有自己的专有数据的。</li>
<li>Groq的AI加速芯片：在芯片层面提速的AI服务。这个之前贾杨青是质疑过其成本的。</li>
<li>贾杨青的Lepton AI是在做AI云原生，能够快速部署大模型应用。</li>
<li>合成数据对AI发展的重要性：随着现实数据逐渐被用完，需要大量的合成数据来训练模型，这方面目前还存在着很多挑战。</li>
</ul>
</li>
<li>贾杨青分享中提到的理查德·萨顿教授的作品《痛苦的教训》中的一句话："从70年的人工智能研究中可以得出的最大教训是，利用计算的通用方法最终是最有效的，而且差距很大。"

<ul>
<li><strong>通用方法</strong>：在人工智能研究中，通用方法指的是那些可以应用于广泛问题的算法和技术，而不是专门为特定问题设计的解决方案。通用方法通常具有更广泛的适用性和更长的生命周期。</li>
<li><strong>利用计算</strong>：这一点强调了计算能力的重要性。在过去的几十年中，计算机的处理能力和速度有了巨大的提升，这使得复杂的算法和大规模数据处理成为可能。</li>
<li><strong>最有效的</strong>：萨顿教授指出，通用方法结合强大的计算能力，往往比特定问题的专用方法更有效。也就是说，使用计算能力来推动通用算法的发展，能够在更大范围内取得成功，并且效果更显著。</li>
<li><strong>差距很大</strong>：这一点强调了效果上的显著差异。萨顿教授认为，通用方法相对于专用方法，其优势不仅仅是略胜一筹，而是有着明显的、显著的效果提升。</li>
<li>总的来说，萨顿教授的这句话提醒我们，在人工智能领域，应该注重发展那些可以广泛应用的通用算法，并充分利用现代计算技术的力量。这样的方法不仅更为高效，而且在各种不同的应用场景中都能表现出色。</li>
</ul>
</li>
<li>美国对新事物的接受度没有那么高，因此Tesla在美国反而没有国内常见。不过，FSD在美国已经全面推行。打Uber的时候司机开启了FSD，整体感觉还是很丝滑的。</li>
<li>美国的油价挺高的，所以日本车在美国占用率很高，随处可见的也是丰田、本田这些车。</li>
<li>Google的Waymo在旧金山随处可见，有同行的朋友有邀请码体验了一下，驾驶没有任何问题，基本和打普通出租车没有任何区别。但其改造一辆车的成本非常昂贵，后来听朋友说，由于特斯拉的RoboTaxi即将发布，Waymo的很多人都离职了。特斯拉的FSD目前看来才是未来的自动驾驶发展方向。</li>
</ol>

]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[CTO都必须是程序员出身吗？为什么架构师做不了CTO？]]></title>
    <link href="https://www.rowkey.cn/blog/2024/04/08/codertocto/"/>
    <updated>2024-04-08T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2024/04/08/codertocto</id>
    <content type="html"><![CDATA[<p>这是来自Quora上的一个问题：<a href="https://www.quora.com/Is-it-required-to-be-a-developer-coder-to-become-a-CTO-Why-cant-an-architect-become-a-CTO">Is it required to be a developer/coder to become a CTO? Why can&rsquo;t an architect become a CTO.</a>
下面是里面的最佳答案。自己比较认同其中的观点，CTO确实是需要有编程背景的，而真正意义上的软件架构师也是具有编程背景的，所以也是可以成为CTO的。</p>

<!-- more -->


<hr />

<p>作为一家创业公司的CTO，你需要了解以下几点：</p>

<p>（1）从上到下对整个技术栈有一个全面的了解，包括每一层的替代方案和取舍权衡。</p>

<p>（2）如何以一种能够给你想要招聘的工程师留下深刻印象的方式进行严肃编程。</p>

<p>（3）如何自我学习你需要了解的技术知识，以及如何在至少100码外就能嗅出技术上的废话。</p>

<p>（4）如何领导工程团队，如何管理工程团队（以及两者之间的区别是什么，因为它们非常不同）。</p>

<p>（5）如何可靠地估计实现其他C级领导愿景所需的工作量。如何向他们沟通可能的权衡，并如何经常从一个过于模糊或过于具体的起点找到真正的需求。</p>

<p>（6）如何向从资深的高级工程师到极其愚蠢的媒体等各方面代表公司的技术愿景。</p>

<p>（7）如何保护你的团队免受不必要的变化，并如何带领他们以及公司其他部分经历必要的变革。</p>

<p>（8）如何指导工程师关于他们的成长和职业目标，无论是作为个体还是团队成员。</p>

<p>（9）如何发现可能的技术和公司问题，并在它们影响工程团队的动力之前清除它们。</p>

<p>（10）如何保持工程团队的持续发展，这可能意味着扮演IT角色，充当工程师，或周末架子搭建者（原文是weekend shelf-builder，不太理解，可能指的是自我驱动去做一些事情的意思）。</p>

<p>你如何达到这个目标？需要你通过在创业公司的工程团队持续工作并向各种听众做技术演讲。从我看着当初我的CTO说“我希望有一天能做到这个位置”，到我准备好自己做这件事，我花了10年的时间。</p>

<p>编辑：既然这个问题有所融合且稍微有所变化，我想直接回应它。</p>

<p>CTO确实可以是一名架构师，但软件架构师是一名开发者。</p>

<p>有些公司有他们称之为“架构师”的人，但他们实际上从未真正建立过系统。他们在销售会议中在白板上画大框和线条，然后就走开了。</p>

<p>我们在Sun公司有一个词来称呼这些人，我们称他们为“市场技术人员（Marketechts）”。并且，一个市场技术人员会成为一个糟糕的CTO，因为他们谈论和思考的是广泛的概括，而不是完成工作的真正细节。</p>
]]></content>
  </entry>
  
  <entry>
    <title type="html"><![CDATA[不同的CTO角色 by Werner Vogels (Amazon CTO)]]></title>
    <link href="https://www.rowkey.cn/blog/2024/04/07/different-cto/"/>
    <updated>2024-04-07T19:29:34+08:00</updated>
    <id>https://www.rowkey.cn/blog/2024/04/07/different-cto</id>
    <content type="html"><![CDATA[<p>这是来自开源项目<a href="https://github.com/kuchin/awesome-cto">awesome-cto</a>的一篇文章，也是自己曾有过的疑问。自己目前担任CTO这个岗位已经6年多了，现在对这个问题的认知：其实CTO这个角色的职责还是要根据CEO的期望来定。初创团队CTO一般就是一个高级开发工程师，随着团队规模增大，会逐渐转换为架构师、技术经理，最后有些CTO会去负责基础技术研究，有些CTO则统管整个研发团队，还有一些则会去管理部分业务。不管如何，这个职责还是要看CEO心里的期望是什么。</p>

<!-- more -->


<hr />

<p>我曾经为一个关于企业创新中首席技术官角色的小型讨论会准备演讲稿，我再次意识到围绕CTO角色存在相当多的混淆。讨论CTO角色时总是首先遇到的问题是，没有一个公认的定义来说明CTO的实际工作内容。这个角色根据公司的类型以及技术在公司中的角色非常不同。</p>

<p>一段时间以前，我做了一些挖掘，研究CTO角色的历史以及如何最好地分类它们。我在这里发布，因为它可能具有普遍的兴趣。一些我使用的来源在这个笔记的末尾。</p>

<p>当Edge的创始人约翰·布罗克曼采访内森·默夫沃德时，他的第一个问题是“什么是CTO”，对此内森回答说：</p>

<p>“我哪知道。你知道的，当比尔和我讨论我接受这份工作时，有一刻他说，好的，那些成功的CTO的杰出例子是什么。大约五分钟后我们决定，好吧，肯定有一些，但我们并没有准确知道谁是伟大的CTO，因为许多实际上是伟大的CTO们并没有那个头衔，至少一些有那个头衔的人可以说并不擅长它。</p>

<p>我的工作是在微软思考未来的技术。如果你想拥有一个伟大的未来，你必须开始在现在思考它，因为当未来到来时，你将没有时间。”</p>

<p>第一个CTO在八十年代末出现。许多公司开始利用其研发实验室交付的结果，这些实验室的主管被提升到可以使用技术为公司提供战略优势的位置。这个角色发展成了非常不同的职位，有几种方式可以对它们进行分类。有充分的理由遵循任何一个分类模型，但我相信汤姆·贝瑞的四象限提供了关于什么使CTO成功的最佳框架：</p>

<ul>
<li>基础设施管理者 - 在CIO的角色变得过于复杂的公司中，CTO承担了基础设施和IT运营的责任：数据中心运营、网络运营、应用开发和维护、安全性和其他直线功能。CIO保留了如何在组织内实际使用技术的责任。这主要是在IT处于纯支持角色的传统业务中使用的模型。</li>
<li>技术愿景家和运营经理 - 这种模式通常在.com和其他以信息技术为关键因素实施商业战略的技术导向公司中发现。CTO负责确定如何使用技术来实施商业战略。这是角色的“技术愿景家”方面。但随后，CTO负责实际集成和运行技术，即“运营经理”的角色。在这种模式中，CTO通常是业务的共同创始人或第一批雇员之一。</li>
<li>面向外部的技术专家 - 我们经常在使用技术为客户和合作伙伴提供产品和服务的公司中看到这种模型；CTO是客户和内部开发之间的中介，并且是产品组合开发的主要影响者。CTO与关键客户保持着不断的联系，并显著参与市场研究。一些较大的软件公司成功使用了这种模式，拥有多个CTO，他们是经验丰富的技术专家，其主要任务是成为客户的桥梁。一些中间件领域的软件公司的CTO还将客户联系描述为他们的主要活动。</li>
<li>大思考者 - 在这个模型中的CTO主要花时间评估如何在内部使用技术来开发新的商业模式和业务线，以及如何预先阻止竞争对手使用技术来颠覆市场。这个CTO的责任通常包括高级技术、竞争分析、技术评估、原型实验室、合作伙伴关系、计划和架构标准。</li>
</ul>


<p>在前两个模型中，CTO直接管理一个工程部门，他/她在组织中的影响力主要通过他们自己组织中的技术开发来施加。我遇到过管理拥有500 - 1000名工程师或更多的部门的CTO。</p>

<p>在最后两个模型中，CTO扮演的角色需要他/她影响其他部门执行新的方向。为了保证这种影响力水平，CTO通常是执行团队的一部分或接近执行团队，通常向CEO汇报。CTO确实监督一个小团队（通常根据公司的大小为10-50名工程师），该团队充当高风险技术方向的孵化器。</p>

<p>以下是一些参考链接。</p>

<ul>
<li>Aspatore Inside the Minds Series, <a href="http://www.amazon.com/gp/redirect.html?ie=UTF8&amp;location=http%3A%2F%2Fwww.amazon.com%2FInside-Minds-Technology-Officers-Peoplesoft%2Fdp%2F1587620561&amp;tag=allthingsdist-20&amp;linkCode=ur2&amp;camp=1789&amp;creative=9325">Leading CTOs</a></li>
<li><a href="http://www.markminevich.com/">Mark Minevich</a>, <a href="http://www.amazon.com/gp/redirect.html?ie=UTF8&amp;location=http%3A%2F%2Fwww.amazon.com%2FCTO-Job-Manual-Leadership-Technology%2Fdp%2F1587623676&amp;tag=allthingsdist-20&amp;linkCode=ur2&amp;camp=1789&amp;creative=9325">The CTO Handbook</a></li>
<li><a href="http://cabotinc.com/berray.html">Tom Berray</a> and Raj Sampath, <a href="http://www.brixtonspa.com/Career/The_Role_of_the_CTO_4Models.pdf">the Role of the CTO: Four Models for Success</a></li>
<li><a href="http://ctonet.blogspot.com/">Roger Smith</a>, <a href="http://www.modelbenders.com/papers/CTOStrategy_SmithR.pdf">the Role of the Chief Technology Officer in Strategic Innovation, Project Execution, and Mentoring</a></li>
<li><a href="http://ctonet.blogspot.com/">Roger Smith</a>, <a href="http://www.ctonet.org/documents/5PatternsofCTO.pdf">5 Patterns of the Chief Technology Officer</a></li>
</ul>


<p>原文链接：<a href="https://www.allthingsdistributed.com/2007/07/the_different_cto_roles.html">https://www.allthingsdistributed.com/2007/07/the_different_cto_roles.html</a></p>
]]></content>
  </entry>
  
</feed>